
FlashAttention 为什么更快、更省显存?它改变了 Attention 的计算结果吗?
🧑💻 面试官:FlashAttention 为什么能加速 Attention?
🙋♂️ 我:它减少了计算过程中对显存的读写,也避免保存完整的大型中间矩阵。
🧑💻 面试官:那是不是少算了一些 token 之间的注意力,变成近似算法了?
🙋♂️ 我:原始 FlashAttention 计算的是精确注意力,不靠删掉关系来提速。
🧑💻 面试官:既然没有少算,为什么还能更快?它把计算复杂度降成线性了吗?
这里要抓住「数据搬运」:算多少是一回事,中间结果在哪里、读写多少次,是另一回事。
面试速答(60 秒版)
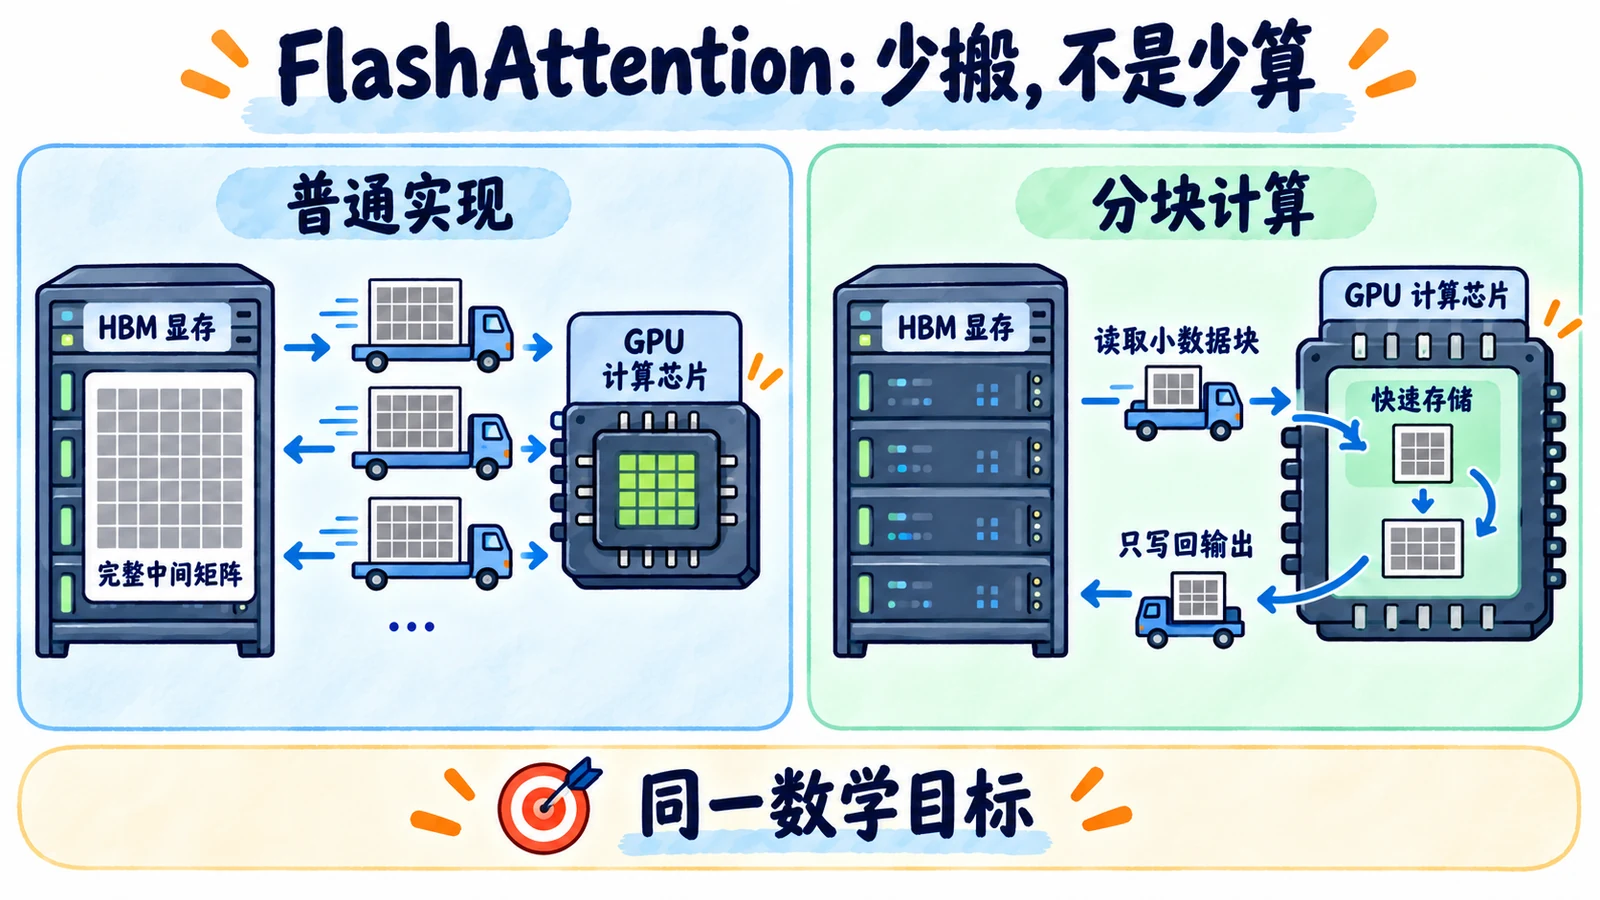
FlashAttention 是一种优化 Attention 计算的算法与实现方式。它的核心思路是分块计算,尽量利用芯片上较小但更快的存储,减少大矩阵在显存中反复写入和读取。
普通实现容易产生完整的注意力分数和概率矩阵。序列变长以后,这些中间结果很占空间,数据搬运也会花很多时间。
FlashAttention 不把完整矩阵留在显存中,而是逐块更新归一化信息和输出。它仍然计算原来那种精确注意力,并不是靠忽略部分位置实现近似。
不过,精确不表示浮点结果逐位相同,也不表示 Attention 的计算量变成线性。实际提速仍要看设备、数据类型、形状和实现,不能把它理解成所有模型都统一快几倍。
知识点详解:没有少算,为什么可以少搬很多数据?
先看普通 Attention 保存了什么
对于一段有 n 个位置的输入,Q 和 K 相乘,会得到一个 n×n 的分数矩阵。经过掩码和 Softmax,再得到各个位置之间的权重,用这些权重对 V 加权,得到输出。
如果把分数矩阵、概率矩阵分别写到显存,后面的算子又把它们读回来,就会产生大量搬运。序列长度翻倍,这类矩阵的元素数量会变成四倍。
假设 n 是 8192,单个矩阵就有六千多万个元素。如果每个元素用两字节,仅这一份中间矩阵就约 128 MiB。这里为了说明规模,暂不计算批量、多头和其他张量;实际实现也未必总把每一份中间结果全部保存。
因此,问题不仅是显卡算得够不够快,也包括这些结果有没有必要全部在显存里经过一遍。
为什么可以边算边更新?
最终要的是加权后的输出,不是完整的概率矩阵本身。
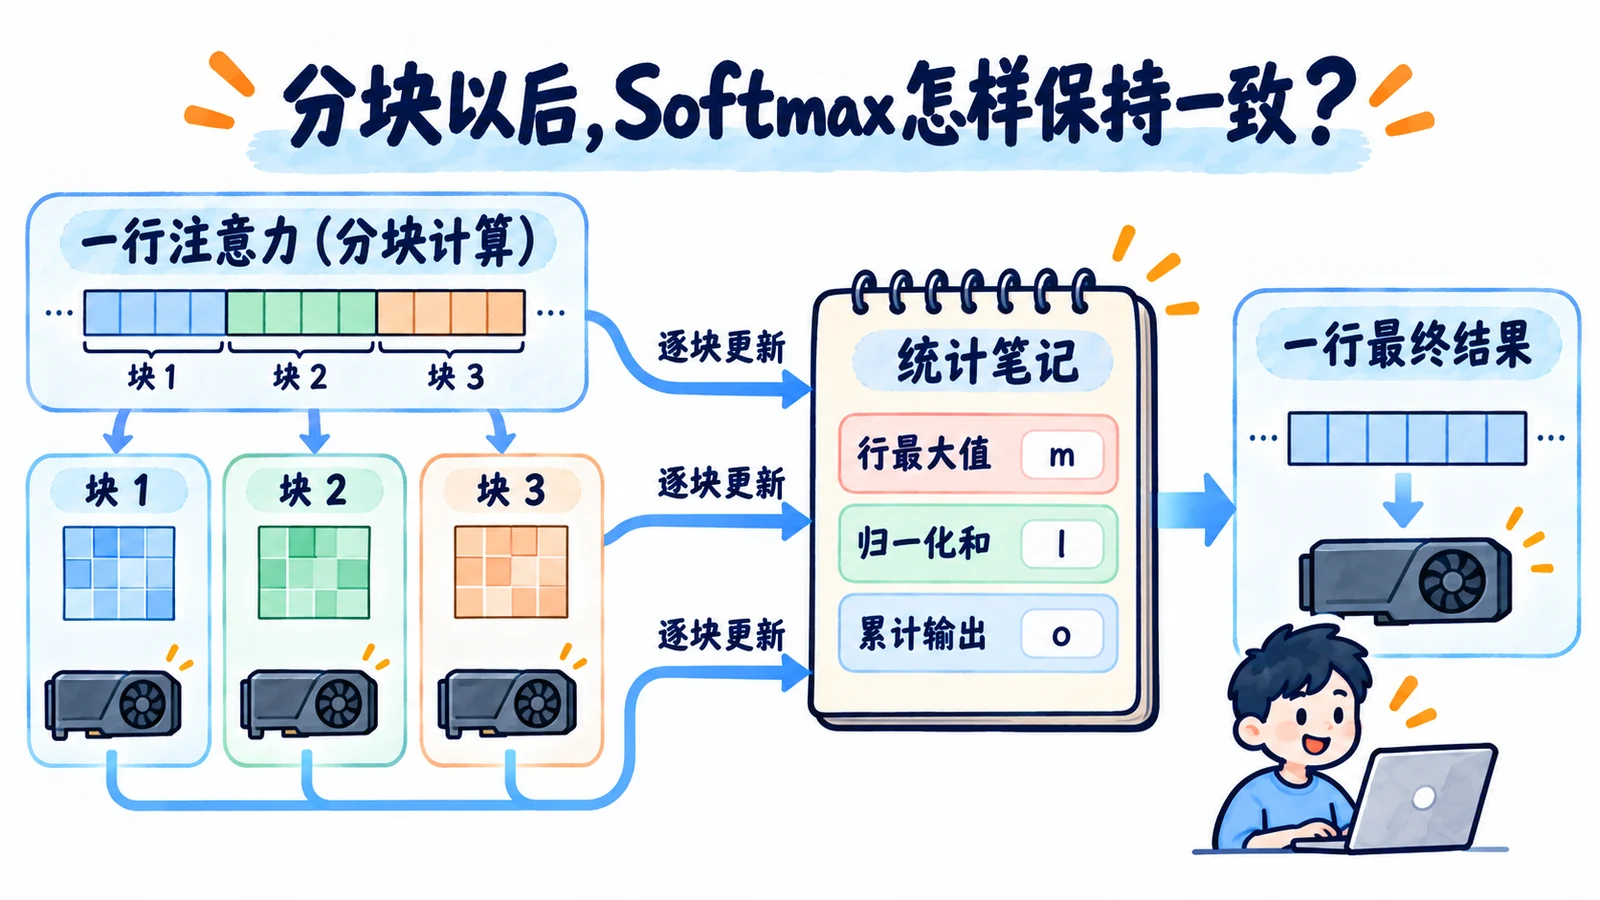
FlashAttention 把 Q、K、V 按块处理,把当前需要的部分放到芯片上的快速存储中。每算一块,就更新当前行的归一化信息和输出,不必把整个 n×n 矩阵长期留在显存。
这里有一个难点:Softmax 的归一化需要考虑整行,不是每块自己算完,再把结果随便相加。
算法会保存并更新行最大值、归一化和等统计量。下一块带来新的最大值时,对已有累计值进行相应缩放,让不同块的结果仍然属于同一个全局 Softmax。也就是通过在线更新,把整行计算拆开,而不是改变数学目标。
FlashAttention 原始论文给出了这一分块算法及其 I/O 分析。理解时,先记住“保存少量统计量与输出,避免保存完整中间矩阵”,比背一个性能倍数更有用。
节省显存,不等于所有内存都变少
它主要减少注意力计算中的中间结果占用。模型权重、KV Cache、其他层的激活与运行缓冲,仍然需要空间。
因此,如果一个服务因为权重太大加载失败,不能指望换一个 Attention 内核就一定解决。如果是长上下文产生的大型中间矩阵占用了很多空间,它的作用才更直接。
训练时也可以通过重新计算部分内容减少保存量。多做一点计算,有时反而比不断搬运大型矩阵更划算,这正是“少算”与“更快”不能简单画等号的原因。
精确注意力,为什么结果仍可能略有不同?
分块以后,加法和归一化的执行顺序可能变化。浮点运算不是无限精确,不同顺序可能带来很小的数值差异。
所以,“精确”是相对于稀疏或其他近似注意力而言,表示计算同一个数学目标,不承诺输出每一位都与另一实现相同。
同时,标准全注意力仍涉及位置之间的成对计算。不要把减少 I/O 和中间存储,误写成计算复杂度从二次变成一次。
面试官继续追问
FlashAttention 和 KV Cache 能互相替代吗?
不能。KV Cache 复用前面 token 的 K、V,避免生成时重复计算;FlashAttention 优化注意力算子的执行与数据搬运。
二者解决不同层面的问题,可以同时使用。KV Cache 管理仍会影响并发和长上下文服务的显存。
只要打开开关,就一定更快吗?
不一定。实现支持的硬件、数据类型、头维度和掩码形式都可能有限制,小形状下收益也可能不明显。
需要确认实际执行的内核,而不是只看配置写了 enabled。基准测试要预热、正确计时并固定输入形状,端到端还要看其他部分是否成为瓶颈。
怎样验证换内核没有把结果算坏?
先比较相同输入下的算子输出,在合理的数值容差内检查误差,再跑任务级回归。
还要测试因果掩码、长序列和边界形状。数值误差可接受,不等于业务结果一定不变;生成任务也应该检查真实回答质量。
面试速记卡
- 提速抓手:减少显存读写,不必靠删掉注意力关系。
- 主要办法:分块计算,在线更新归一化信息和输出。
- 精确含义:数学目标不变,浮点结果未必逐位一致。
- 复杂度边界:不能把 I/O 优化说成全注意力线性计算。
- 作用范围:中间结果更省,不代表权重与 KV Cache 自动变小。