
大模型量化是什么?INT8、INT4 如何影响显存、速度和效果?
🧑💻 面试官:一个模型显存放不下,改成 INT4 是不是就解决了?
🙋♂️ 我:权重用更低位宽存储,可以减少显存占用。
🧑💻 面试官:16 位变成 4 位,整个服务的显存和耗时都变成四分之一吗?
🙋♂️ 我:不一定,服务还有 KV Cache 和其他内存,也要看计算支持。
🧑💻 面试官:模型现在能加载了,但并发长文本请求还是 OOM,回答还偶尔漏数字。下一步怎么查?
量化先改变「数值表示」,是否省得够、跑得快、答得准,需要分别确认。
面试速答(60 秒版)
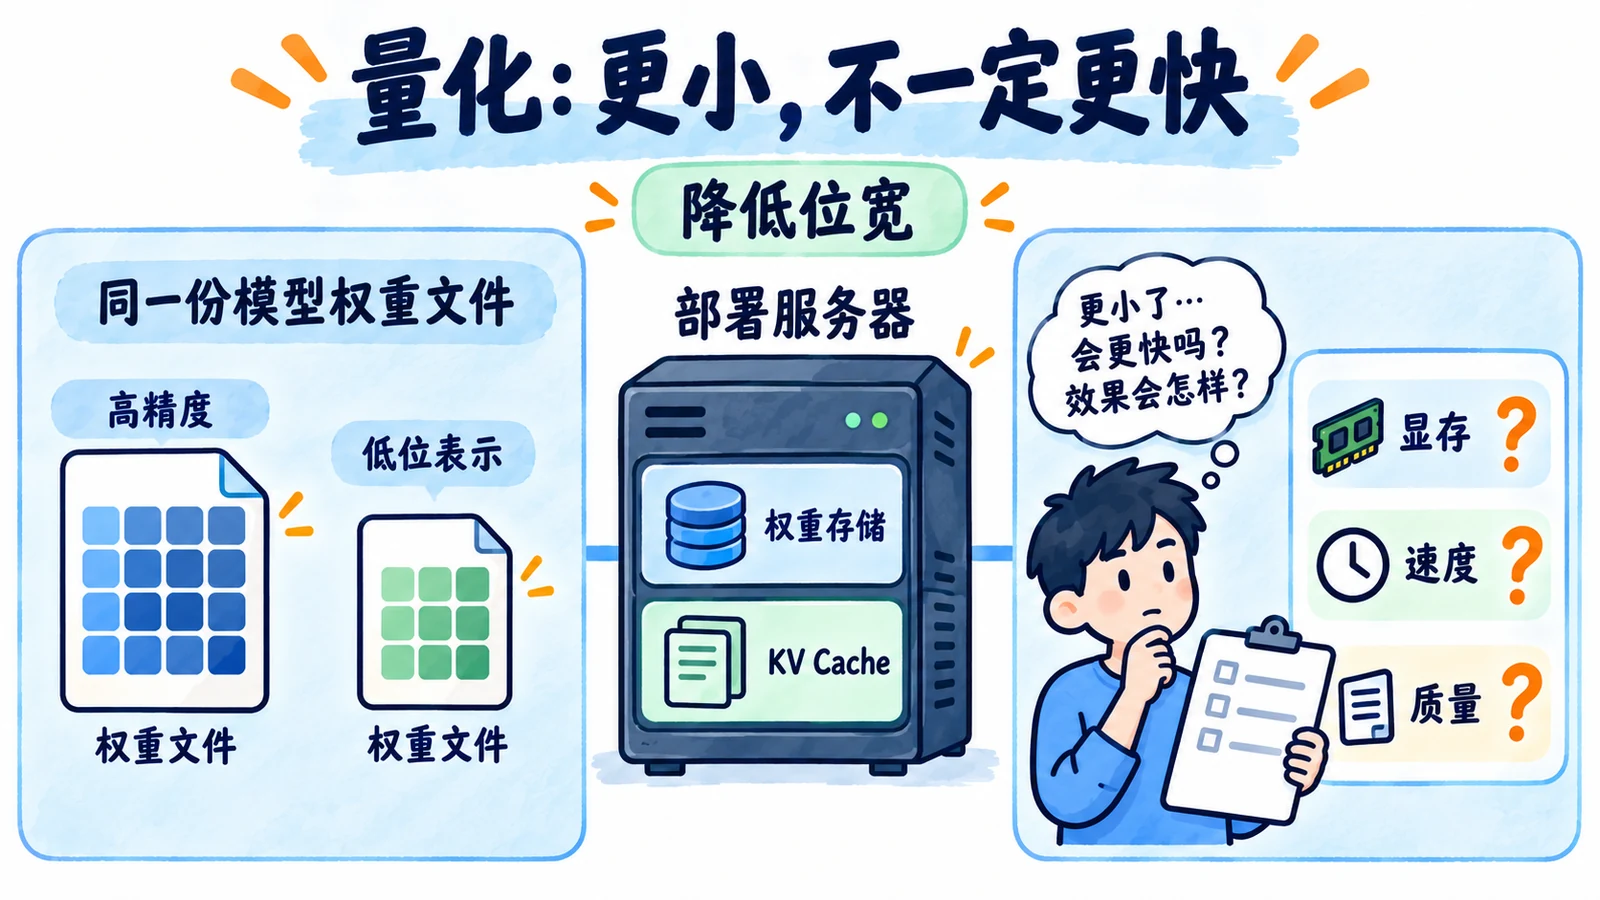
大模型量化,是用较低精度表示模型中的数值。常见做法是把原来 16 位的权重压到 8 位或者 4 位,减少权重存储和数据搬运的开销。
但 INT4 不代表整个模型所有计算都使用 4 位,也不代表总显存一定减少到四分之一。量化参数、未量化模块、KV Cache 和运行缓冲仍然会占空间。
同时,速度取决于硬件和量化算子是否匹配。有些方案减少了显存,却因为解量化和计算开销,没有带来预期的提速。
因此,选择量化方案时,要用实际请求测试质量、延迟、吞吐和峰值显存。尤其检查长上下文、数字和工具参数,不能只确认模型可以加载,就认为部署已经完成。
知识点详解:少存几位,模型为什么还能计算?
量化不是把参数直接截掉几位
咱们先看一个简化的例子。原来的权重是小数,量化后用有限的整数档位表示它,再配合缩放因子,把整数还原到近似的数值范围。
原本相近的两个小数,可能被放进同一个档位;超过表示范围的值,也可能被截到边界。因此,量化会引入误差。
缩放方式可以按张量、通道或分组安排。分得更细,可能更容易兼顾不同数值范围,但也需要保存更多辅助信息。这里讲的是基本关系,不代表所有 INT4 方法都使用完全相同的映射。
W4A16 和“全程 4 位”有什么不同?
W 通常表示权重,A 表示激活。W4A16 的意思是权重使用 4 位表示,而激活使用 16 位表示。
计算时,具体内核可能把低位权重转换到适合运算的形式,或者使用硬件支持的低精度运算。累加结果也不一定与存储使用同一精度。
因此,看到“INT4 模型”时,要继续问清楚哪些部分量化、计算使用什么方式,而不是把所有张量都当成 4 位。Hugging Face 的量化说明也区分了不同方法与硬件支持,不能只按位数选包。
为什么模型加载成功,长请求还是放不下?
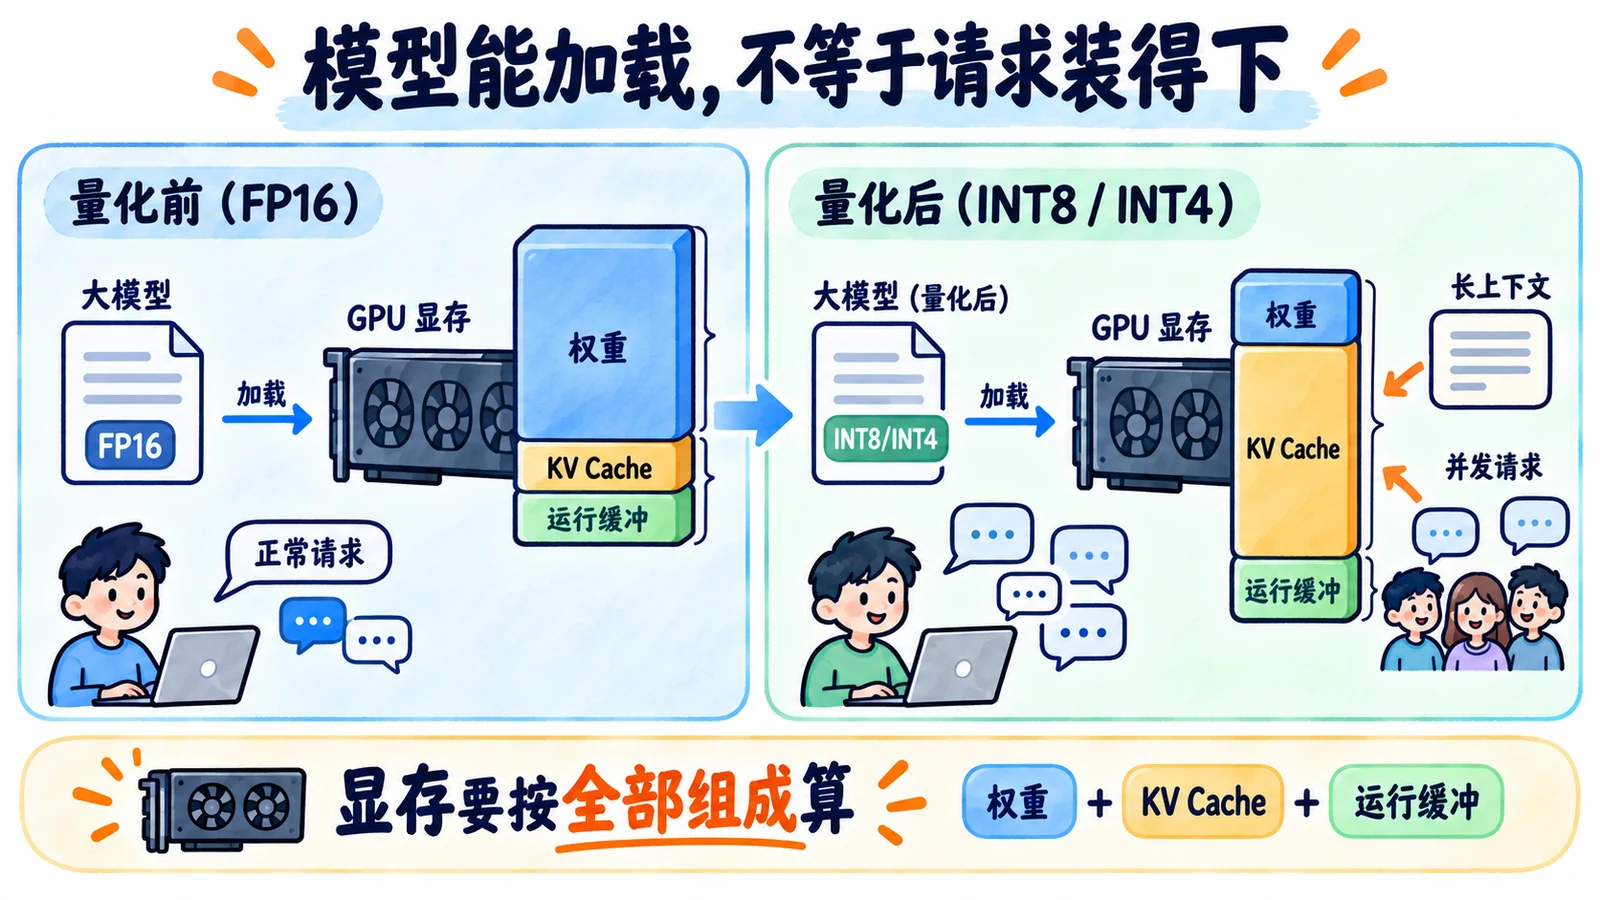
假设一个 7B 模型的权重原来按 16 位存储,只算权重本身,大约需要 14 GB;按 4 位计算,原始位宽对应约 3.5 GB。这里按十进制字节粗算,不是实际部署的完整显存。
量化还需要缩放因子等辅助数据,有些模块保持更高精度。服务运行后,KV Cache 随上下文长度、批量以及模型结构增长,还会有中间结果和运行缓冲。
因此,模型在空闲时能装进显存,不代表同时处理多个长请求也够用。排查时要拆开权重占用、请求缓存和执行峰值,不能继续降低权重精度,却忽略真正增长的是 KV Cache。
KV Cache 量化也可以考虑,但它是另一个需要评估的选择,不能因为权重量化了,就默认缓存也一起变小。
为什么省显存,却可能没变快?
低位权重减少了搬运数据的量,如果任务主要受内存带宽限制,而且内核优化合适,就可能提速。
但硬件可能不支持对应运算,或者小批量下转换与调度开销更显眼。长输入的处理和逐 token 生成也可能有不同瓶颈,所以首字延迟和生成速度不一定一起改善。
测试时,保留相同模型任务、输入输出长度和并发条件,比较原精度与量化版本。不能让量化版本输出更短,再把总耗时降低说成算子提速。
面试官继续追问
INT8 一定比 INT4 准确吗?
在相同条件下,更细的数值档位通常更容易保留精度,但最终效果也受量化方法、校准数据和模型影响。
应检查业务样本:数字是否变化、长文是否漏条件、生成的工具参数是否正确。不要只用几个闲聊问题判断模型有没有损失。
校准数据应该怎么选?
如果方法需要校准,应尽量覆盖实际任务的文本长度、语言、格式和领域。
例如,部署给代码助手,却只使用短新闻校准,不能认为已经验证代码场景。校准样本与最终评测样本也应分开,避免只在熟悉材料上看到好结果。
量化能代替微调吗?
不能。量化主要改变数值表示,微调通过训练改变参数,让模型适应任务。
它们可以结合,例如先得到适合业务的模型,再做部署量化;部分训练方法也会使用量化基础权重。但“更小”并不等于“更懂业务”。
面试速记卡
- 量化:降低数值表示精度,主要节省相关张量的存储。
- 看清范围:权重、激活、KV Cache 不一定使用同一精度。
- 显存账单:权重之外还有辅助参数、缓存和执行峰值。
- 速度条件:硬件、内核和请求负载需要匹配。
- 上线依据:同时验证业务质量、峰值显存、延迟与吞吐。