
Redis 和数据库如何保持一致?为什么更新数据库后删缓存,仍然可能读到旧数据?
🧑💻 面试官:任务状态缓存在 Redis 中,任务完成以后,你会怎样更新?
🙋♂️ 我:先把数据库改成完成,再删除缓存。下次读不到缓存,就去查数据库。
🧑💻 面试官:删除成功了,是不是之后每个请求都能读到最新状态?
🙋♂️ 我:如果有其他请求正在查询,可能还需要考虑并发。
🧑💻 面试官:一个请求已经从数据库读到了旧状态,但还没来得及写缓存。这时更新和删除都完成了,它再把旧状态写进去,会发生什么?
这道题的关键是:「旧数据还会不会被写回来」。删掉已有缓存,不等于取消了所有正在执行的读请求。
面试速答(60 秒版)
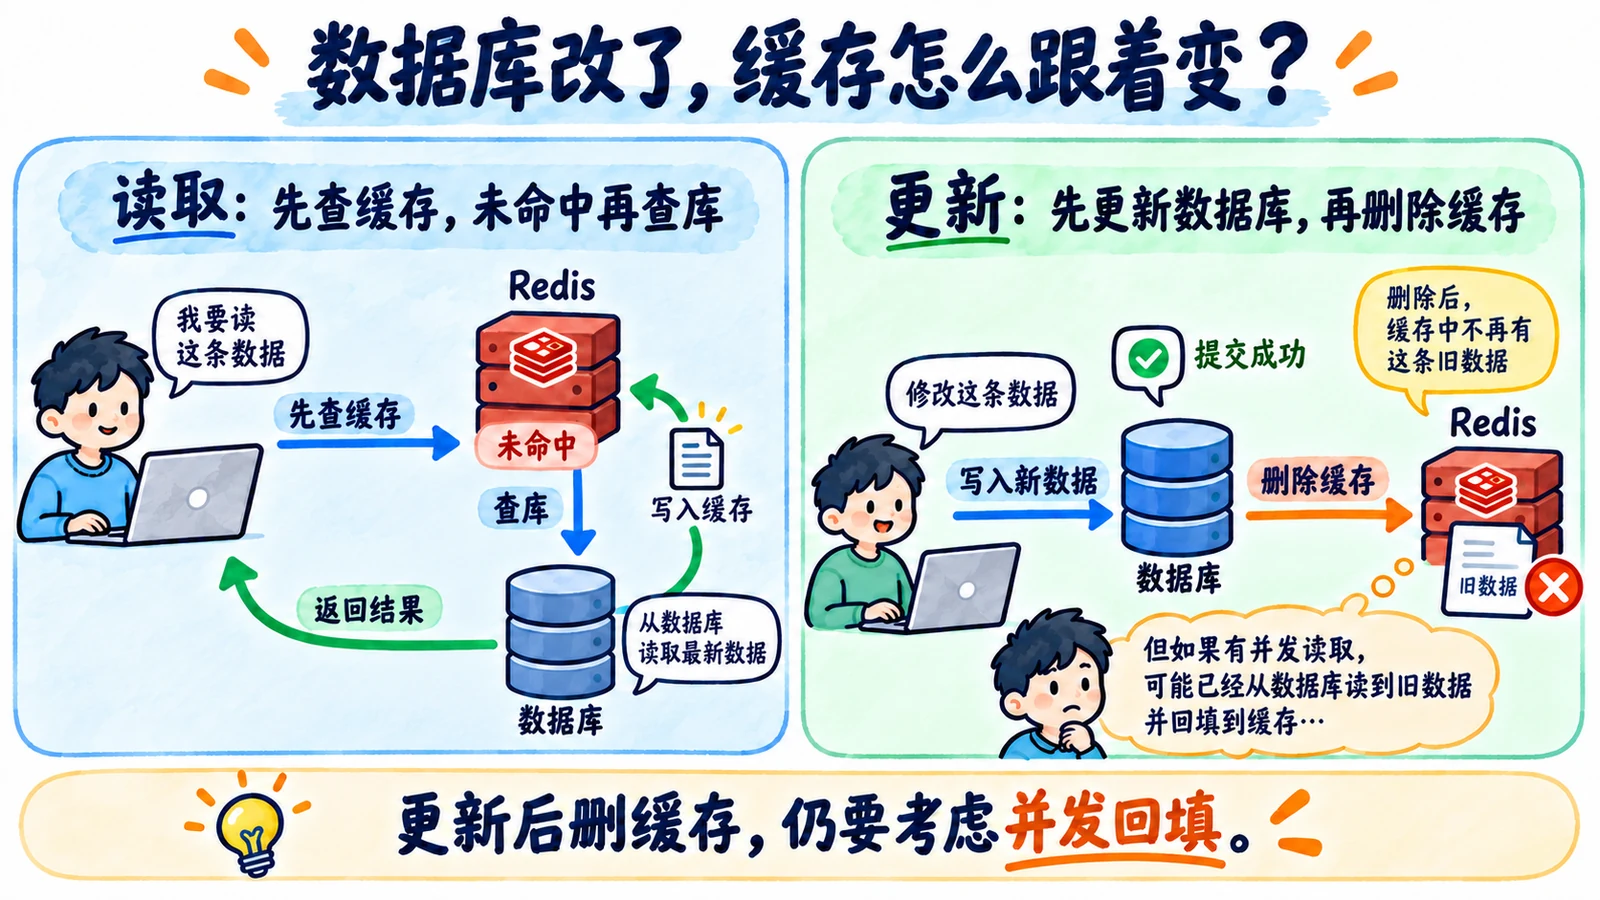
Redis 和数据库使用 Cache-Aside 时,通常先读缓存,未命中再查数据库并回填;修改数据时,先提交数据库更新,再删除对应缓存。
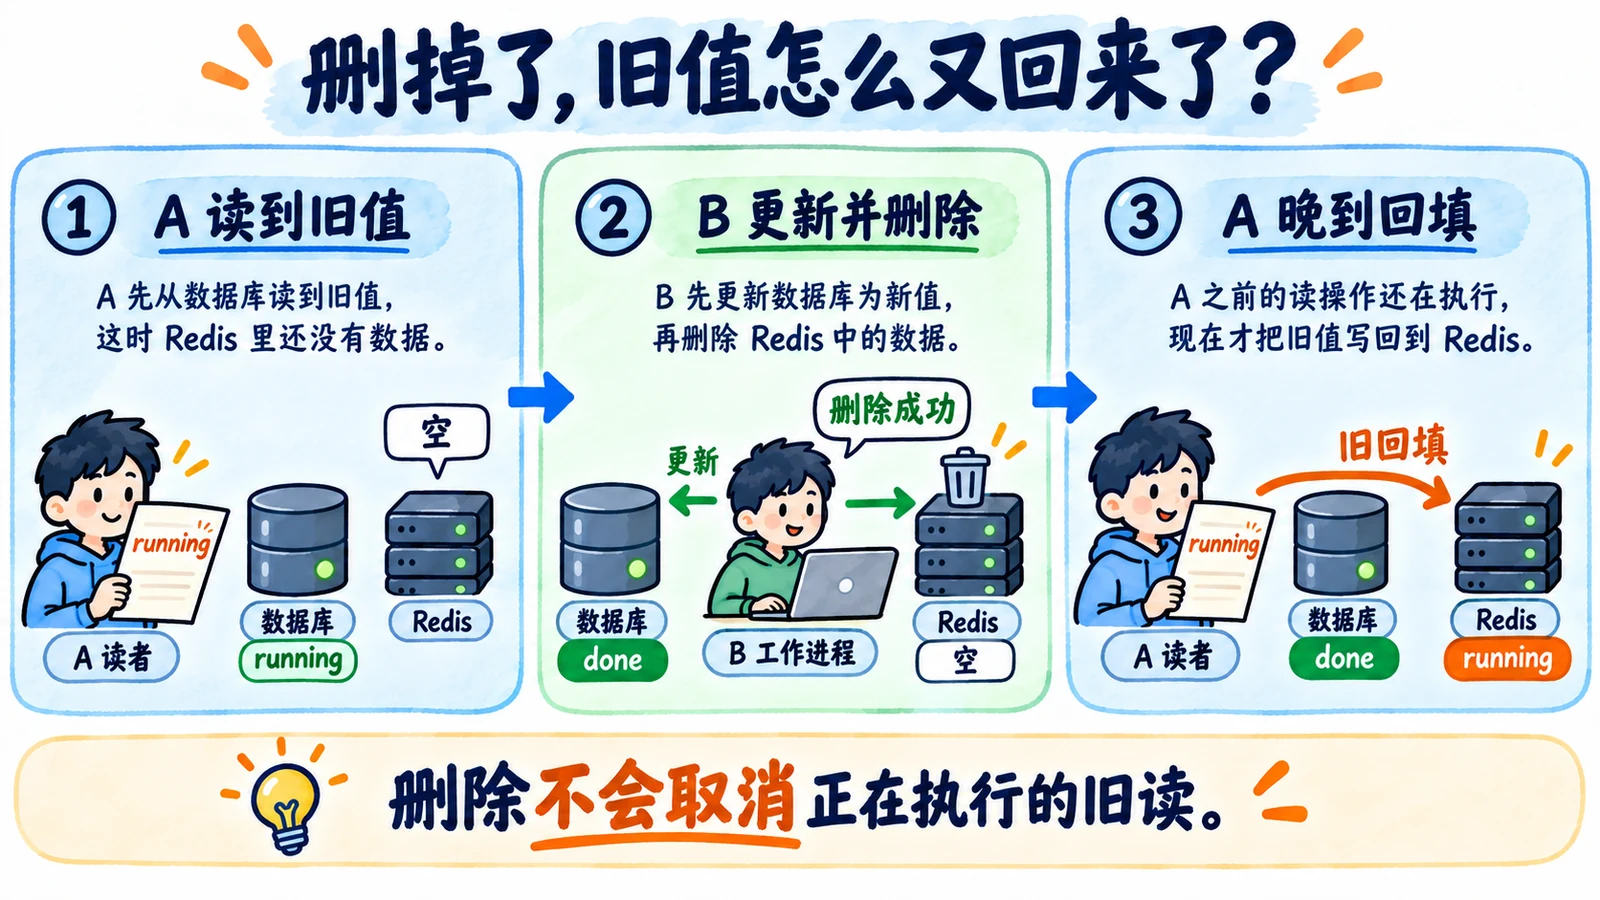
但是,这个顺序不能保证每个并发请求都读到最新值。一个请求可能先读到了数据库旧值,另一个请求随后更新数据库并删除缓存,前一个请求最后又把旧值写回缓存。
因此,还要根据业务能接受多旧的数据,设计过期时间、失效重试和必要的并发控制。删除失败不能直接忽略,可以保存可靠的失效任务,在失败后补做。
如果是余额、权限等必须准确判断的数据,就不应该只依赖缓存中的旧值。关键操作需要读取权威数据并校验。延迟双删可以缓解部分竞态,但不能单独证明 Redis 和数据库已经强一致。
知识点详解:删缓存成功,旧状态怎样又回来了?
先顺着一次普通查询,看看缓存怎么产生
假设咱们的 Agent 任务有两个状态:running 和 done。用户打开任务详情页,应用需要显示当前状态。
使用 Cache-Aside 时,应用先查询 Redis。如果命中,就使用缓存中的状态;如果没有命中,应用查询数据库,再把查询结果写入 Redis,同时设置过期时间。
任务完成时,工作进程先在数据库中把状态改成 done,提交成功以后,再删除对应缓存。这样,后面的缓存未命中请求就可以重新读取数据库。
Redis 的 Cache-Aside 说明介绍的就是这种由应用负责查询、回填和失效的方式。
注意,这里不是数据库和 Redis 自动一起提交事务。数据库提交成功,并不代表 Redis 删除也一定成功;回填请求也不会因为数据库更新了,就自动停止。
删除没有失败,为什么还会读到旧值?
咱们假设缓存一开始没有这条任务的数据。两个请求按照下面的顺序执行:
| 顺序 | 读请求 A | 工作进程 B |
|---|---|---|
| 1 | 缓存未命中,查询数据库,拿到 running | — |
| 2 | 暂时还没有回填缓存 | 把数据库改成 done,提交 |
| 3 | 仍未回填 | 删除缓存成功,此时缓存中没有该键 |
| 4 | 把之前拿到的 running 写入缓存 | — |
| 5 | 新请求命中缓存,读到 running | 数据库其实已经是 done |
这里没有必要假设 Redis 出故障,也不需要让删除操作失败。
问题在于,A 拿到旧值以后,B 完成了更新和删除,而 A 并不知道这些变化,继续按原来的读流程回填。
因此,删除缓存只能处理当时已经存在的内容,不能阻止后来到达的旧回填。先更新数据库再删缓存,是常见的失效顺序,但不是强一致的证明。
把顺序改成先删缓存再改数据库,也不是直接解决。两个操作之间,其他请求仍然可能读到旧数据库值并回填。分析这类问题,要把读、写和回填都画出来,不能只排列两个写操作。
过期、重试和延迟双删,各自补什么问题?
过期时间 可以减少旧值长期残留的风险。不过,TTL 从某次写入缓存时开始计时;晚到的旧回填,仍然可能产生新的过期窗口。它不会保证数据库一更新,所有读取立即变新。
可靠失效重试 主要处理删除失败。例如,可以把需要失效的键记录成持久化任务,失败后继续补做。
如果要求数据库更新后一定留下这项任务,可以在同一数据库事务中保存业务变更和 Outbox 记录,再由后台投递失效事件。Debezium 的 Outbox 介绍展示了这类事件传播结构。这里仍要处理重复事件、积压和删除失败;它也不会自动阻止前面 A 的晚到回填。
延迟双删 是在更新后删除一次,等待一段时间,再删除一次,希望把期间回填的旧值清掉。
但这个等待时间没有办法天然覆盖所有读请求。A 如果停顿得更久,可能在第二次删除以后才写入旧值。因此,延迟双删可以缓解特定时序,不能凭一个固定延迟承诺“绝不会读旧”。
这三种做法处理的问题不同,不应该把其中一种写成所有一致性问题的答案。
什么业务,不能只靠这些补救?
任务进度页可能允许短时间显示 running,用户稍后刷新即可。但即使如此,也应该定义允许延迟多久、异常时如何回源,以及怎样避免完成状态反复倒退。
换成退款额度、支付余额或操作权限,就不能只拿缓存值作最终决策。页面可以显示缓存信息,但实际执行前,要由可信服务根据权威数据重新检查,并在需要时使用事务等方式保证业务条件。
如果还要使用版本号防止旧回填,也必须设计完整比较规则。例如,在缓存里附带版本号,但缓存已经被删除,旧请求照样可能把旧版本写进去。单独多加一个字段,并不能阻止这个时序。
需要更严格的保证时,读和写双方都要遵守相应的版本屏障或协调协议,并处理失效和恢复。这会增加复杂度。因此,应该先说清业务的一致性要求,再选择合适方案,而不是给所有字段都套上同一种缓存策略。
面试官继续追问
删除缓存失败,直接回滚数据库可以吗?
通常不能这样处理。数据库已经提交后,不是简单执行一个回滚,就能撤销这个已完成事务。
需要把缓存失效当成另一个可能失败的步骤,记录并补做。若业务需要补偿,也要按业务规则设计,不能把补偿更新说成原事务回滚。
用分布式锁保护回填,就一定安全吗?
要看所有相关读写是否遵守同一规则,锁是否过期,以及旧请求是否还能在失去锁以后写入。
只锁住某一个代码入口,其他写入路径不配合,就无法证明一致性。还需要考虑故障恢复和旧持有者的动作。
用户更新后,立刻读取自己的结果怎么办?
可以让这次读取走权威数据,或使用已经明确校验的版本,让应用知道返回内容是否至少包含本次更新。
具体选择要看性能和业务要求。不能只说“TTL 很短”,因为短暂读到旧值仍然可能违背这次操作的预期。
面试速记卡
- Cache-Aside:缓存未命中读库回填,写库提交后使缓存失效。
- 并发漏洞:旧读可以在删除成功以后,重新写回旧值。
- TTL:控制缓存残留,不保证更新后每次读取立即变新。
- 可靠重试:处理失效失败,不自动解决全部回填竞态。
- 延迟双删:缓解部分时序,固定等待不能证明强一致。
- 关键决策:余额、权限等操作读取权威数据并重新校验。