
vLLM 为什么快?PagedAttention 和连续批处理分别解决什么问题?
🧑💻 面试官:vLLM 为什么能提高大模型服务吞吐?
🙋♂️ 我:它能更好地管理 KV Cache,也能把多个请求一起调度。
🧑💻 面试官:我把十个请求同时发出去,不就是连续批处理了吗?
🙋♂️ 我:客户端同时发送请求,不代表服务端每轮都重新安排执行批次。
🧑💻 面试官:换成 vLLM 以后,总吞吐提高了,某些用户的首字却更慢。你觉得这两个结果矛盾吗?
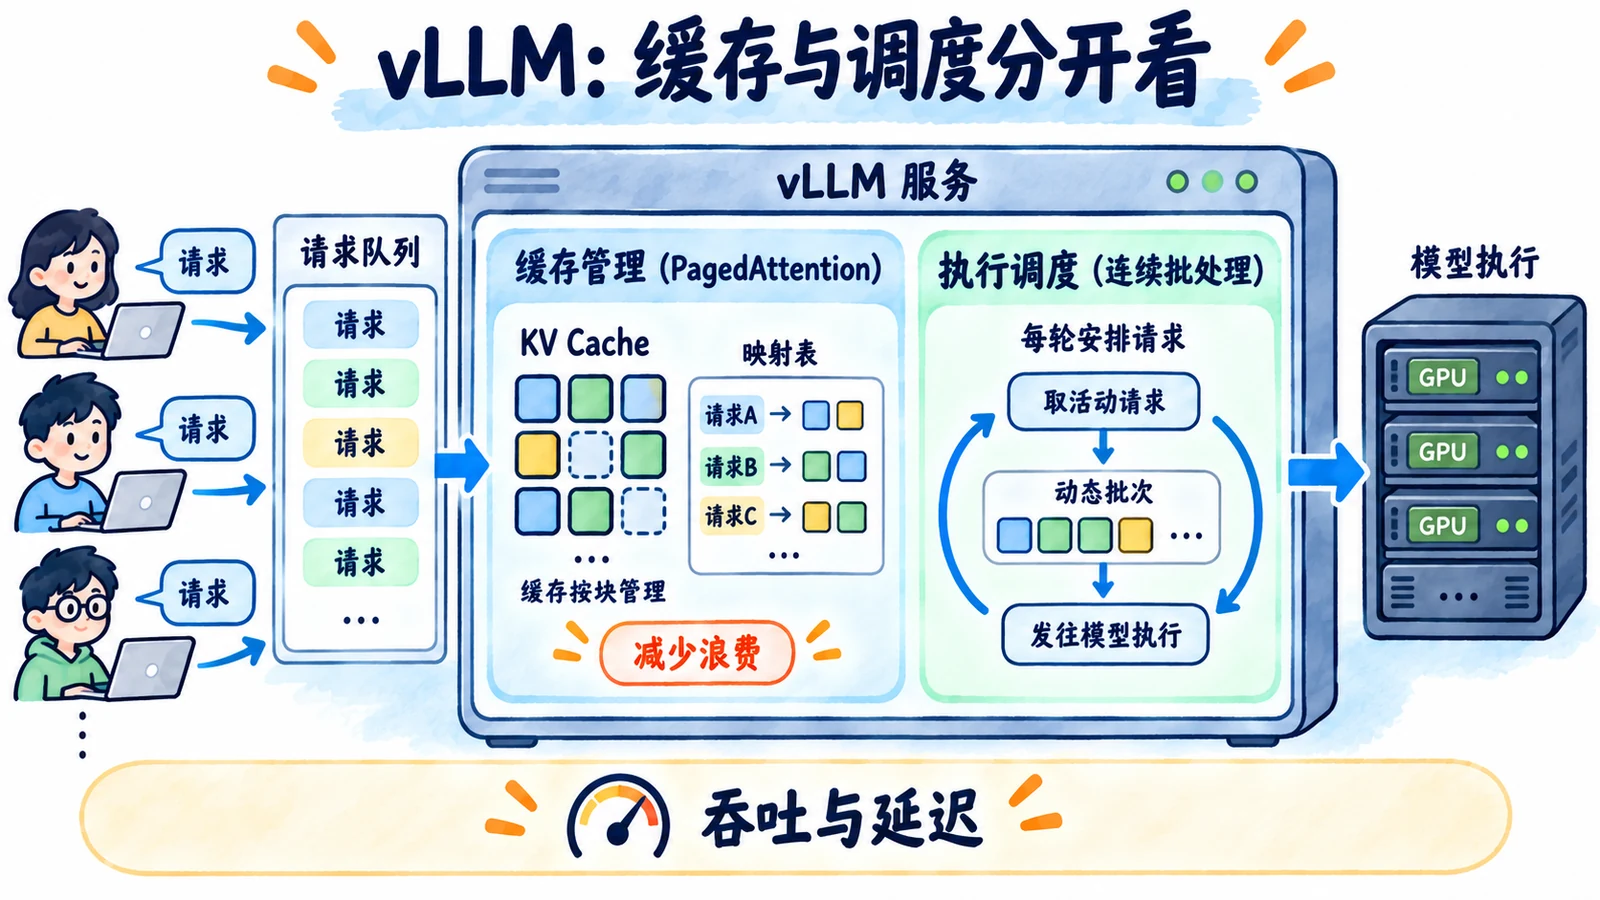
这道题要分开看:「显存怎样用」决定能容纳什么,「每轮怎样排」决定谁在什么时候获得计算机会。
面试速答(60 秒版)
vLLM 是大模型推理服务系统,它的性能来自多项设计,不能只归因于一个算子。
PagedAttention 的核心思路,是把 KV Cache 按块管理,再用映射找到请求需要的缓存,减少大块连续预留和碎片带来的浪费。
连续批处理则是在生成过程中动态安排请求。一个请求结束以后,可以让等待中的请求进入后续批次,不必等整批里最长的请求全部完成。
因此,两者分别处理缓存管理和执行调度。但吞吐提高不代表每个请求都更快,排队、输入长度和调度策略仍会影响首字延迟。实际选型要在相同模型和负载下,同时比较吞吐、尾部延迟与显存。
知识点详解:服务怎样同时照顾长短不同的请求?
KV Cache 为什么不好分配?
生成答案时,模型会保存前面 token 对应的 K、V,后续计算可以复用它们。
问题在于,服务刚收到请求时,不知道最终会生成多少 token。如果给每个请求预留最大长度的连续空间,短答案就会占着没用到的部分;频繁分配和释放也会产生碎片。
假设显存里还有不少空闲空间,却分散成许多小段。需要一大块连续区域的请求就可能无法使用它们。此时,限制并发的未必是总空间用光了,而是管理方式不够灵活。
分页管理把什么关系拆开了?
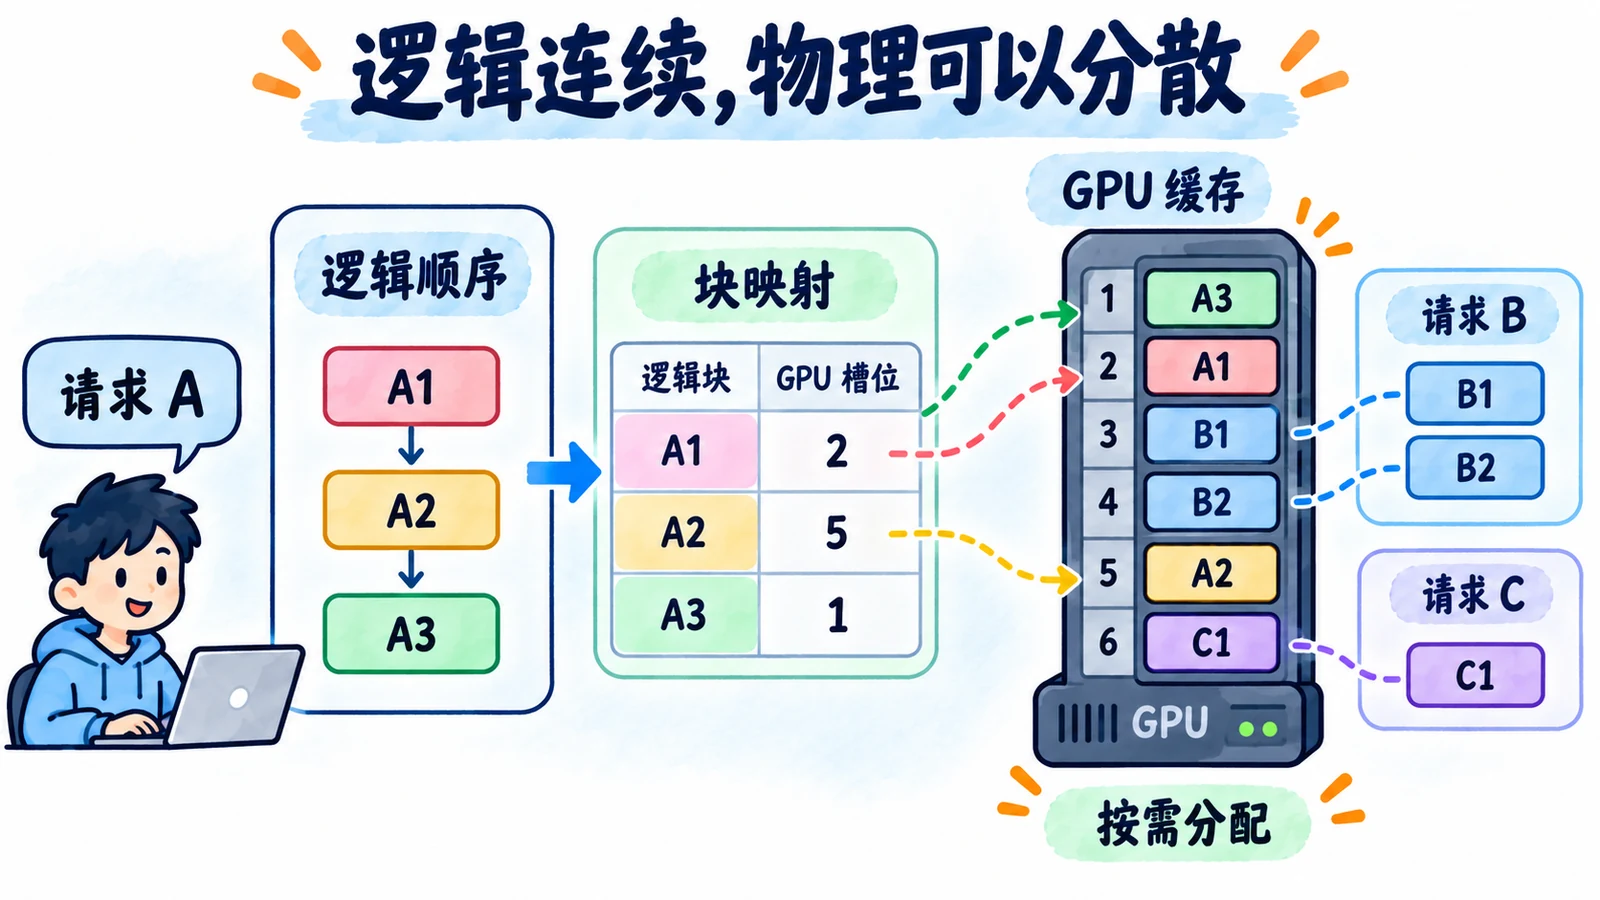
PagedAttention 把请求的逻辑 token 序列与物理缓存块分开。
一个请求的 KV Cache 可以保存在不同位置的块中。服务维护映射,注意力计算根据映射找到所需内容。随着生成长度增加,再分配新的块,不必一开始就为最大输出预留整片连续区域。
它借用了操作系统分页的思路,但不是把缓存自动搬到磁盘,也不是把 KV Cache 全部压缩。最后一块仍可能有空闲,管理本身也有成本,不能说显存浪费完全消失。
这里解释的是原始 PagedAttention 论文的核心思想。vLLM 的历史设计文档明确提示,该页已不对应今天的具体代码;分析当前版本的内核和调度参数,还需要按版本查实现。
连续批处理为什么不等最长的请求?
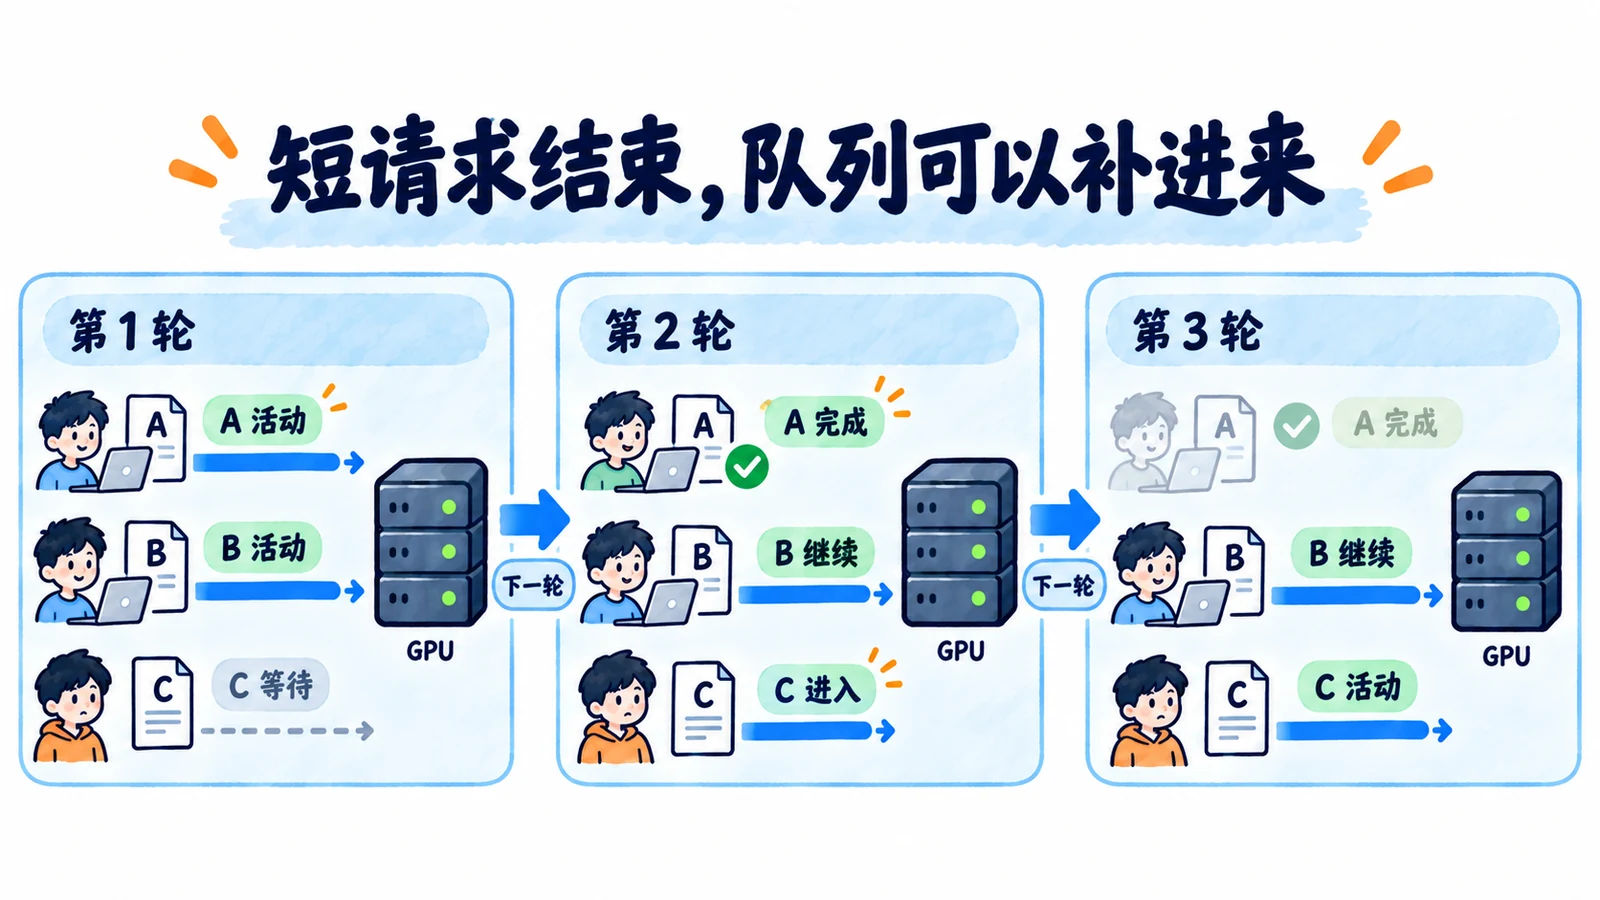
假设 A 只要生成 10 个 token,B 要生成 100 个,C 还在队列里等待。
固定批次如果一直把 A 和 B 绑定在一起,A 完成后,空出来的处理能力未必能马上服务 C。C 可能要等 B 结束,再进入下一批。
连续批处理会在生成迭代之间调整活动请求。A 完成,就释放相应资源;资源和调度条件允许时,C 进入后续迭代,与 B 一起继续计算。
这不是 A 没完成就突然换成 C,也不是客户端使用并发请求就自动得到的效果。服务端必须安排当前有哪些请求执行、缓存如何分配,以及新请求的输入处理什么时候进行。
首字和后续生成,可能争同一份资源
新请求需要先处理输入,已经开始回答的请求则要继续 Decode。
一个很长的新输入,如果占用大量计算时间,其他请求的后续输出可能停顿。反过来,一直优先已开始的生成,也可能让新用户排队很久。
实际系统可以使用分块处理输入、预算和调度策略来平衡,但具体能力与配置依版本而异。没有一种策略能让所有负载下的吞吐和延迟都同时达到最好。
因此,评测要保留真实的输入长度、输出长度、到达速率和并发分布。首字延迟、相邻 token 的等待、任务总耗时,以及服务实际处理的 token 数,都值得分别看。
面试官继续追问
PagedAttention 和 FlashAttention 是一回事吗?
不是。前者重点解释服务如何组织和访问请求的 KV Cache;后者重点优化 Attention 计算中的显存读写。
两种思路可以出现在同一套服务中,实际内核也会相互结合。回答时先讲各自解决的问题,比记住两个名字更重要。
批量越大,吞吐一定越高吗?
不一定。增加批量可能提高设备利用率,也会增加缓存需求和等待。
当显存不足、长请求挤占资源或排队过多时,用户体验会变差。应该找到质量和延迟约束下的合适负载,不是把显卡打满就算优化成功。
怎么证明优化不是因为测试请求更短?
固定模型、硬件、采样要求与输入输出分布,再对照不同服务配置。
记录实际输出长度和成功请求数,把失败、超时也算进去。不能只统计成功的短请求,也不能把更激进的截断当成推理服务提速。
面试速记卡
- PagedAttention:按块组织 KV Cache,逻辑顺序不要求物理连续。
- 连续批处理:在执行迭代间动态调整活动请求。
- 不等于客户端并发:服务端需要真正完成资源与调度安排。
- 指标分开:吞吐提高,不保证首字和尾部延迟同时改善。
- 版本边界:原论文解释思想,当前实现和配置按版本核对。