
Agent 执行越来越慢,应该怎么定位性能瓶颈?
🧑💻 面试官:一个企业调研 Agent,以前很快就能生成报告,现在经常要等很久,你会怎么排查?
🙋♂️ 我:先看看是不是上下文变长了,或者换一个响应更快的模型。
🧑💻 面试官:每次模型调用的耗时没怎么变,但一次任务从调用三次变成了八次。换模型能解决这个问题吗?
🙋♂️ 我:那还需要看,它为什么多执行了这么多轮。
🧑💻 面试官:还有一批请求,模型根本没开始调用,用户就已经等了十几秒。这个时间又应该记在哪里?
这道题要抓住的是:「时间花在哪里」。模型慢、工具慢、执行轮次多、任务排队,看起来都是等得久,处理方法却不同。
面试速答(60 秒版)
Agent 执行变慢,不能直接判断是大模型的问题,需要先把一次任务的耗时拆开。
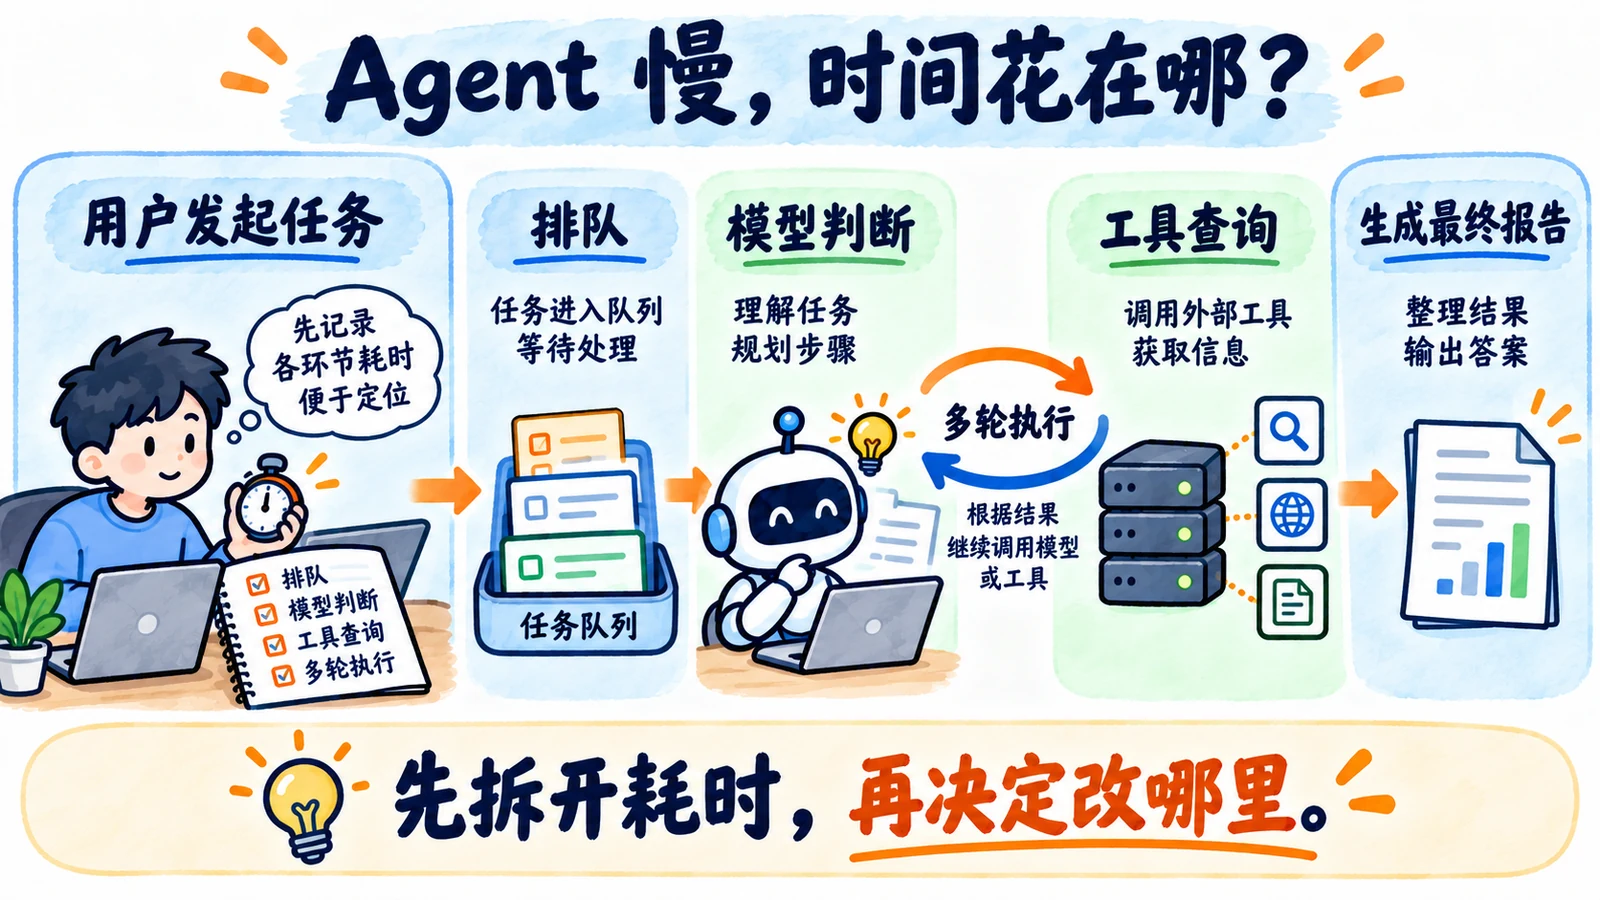
例如,用户提交任务后,可能先在队列里等待。开始执行以后,又会经历模型判断、工具调用和多轮重试。因此,应该记录这些步骤的开始时间、结束时间和调用次数,找到哪一部分发生了变化。
如果单次模型调用变慢,再检查输入长度、输出长度和模型服务;如果工具耗时增加,就检查下游接口、连接池和重试;如果每一步都不慢,但执行轮次变多,就要看模型为什么没有及时完成任务。
同时,优化后要用同一批任务重新验证,比较整体耗时和任务完成情况。不能因为少查了必要资料、提前给出了不完整答案,就认为性能变好了。
知识点详解:怎样把 Agent 的慢,定位到具体步骤?
用户等了多久,和模型生成了多久,不是一回事
假设咱们做了一个企业调研功能。用户输入公司名称,Agent 搜索资料、读取网页,最后生成报告。
用户关心的是:从点击提交,到报告可以使用,一共等了多久。
但是程序里面可能有好几段等待。任务先排队,运行器拿到任务后调用模型,模型提出搜索请求,工具执行搜索,然后运行器再把搜索结果交给模型。
因此,只记录模型接口的响应时间,解释不了整个任务的耗时。 队列里的等待,发生在模型调用之前,也要计入用户的等待时间。
为了看清这些过程,可以给一次任务设置一个追踪标识,把内部的模型和工具调用关联起来。这份按执行顺序保存的记录,就是这里说的 Trace。LangSmith 的概念文档把整次操作和内部调用分别表示为 Trace 与 Run。
不过,追踪工具没有自动采集到的地方,还需要应用补充记录。例如,入队时间、工作进程领取任务的时间,就不能想当然地认为模型 SDK 已经记录了。
先比较变化,再决定查哪一段
假设新旧版本的记录如下。数字只是为了讲清排查过程,不是某个模型的性能结论。
| 观察项 | 旧版本 | 新版本 |
|---|---|---|
| 等待工作进程领取任务 | 很短 | 明显变长 |
| 单次模型调用 | 变化不大 | 变化不大 |
| 模型调用次数 | 3 次 | 8 次 |
| 搜索工具 | 通常一次成功 | 经常超时后重试 |
这份记录已经说明,换一个更快的模型,不一定是最值得先做的事。
排队变长,需要检查任务量、可用工作进程和并发限制。搜索重试增多,需要看下游接口是否限流、连接是否不足,以及超时设置是不是不合理。
至于模型从三轮执行到八轮,要继续打开每一轮的输入和结果。是不是搜索没有返回有效内容?是不是工具结果太长,模型没找到需要的信息?还是完成条件写得不清楚,已经收集够了资料,却一直继续搜索?
这些问题都会让任务变慢,但改动的位置不同。先找到变化,才知道接下来应该改什么。
哪个步骤耗时最长,就先优化哪个吗?
还需要看,这个步骤有没有拖住整个任务。
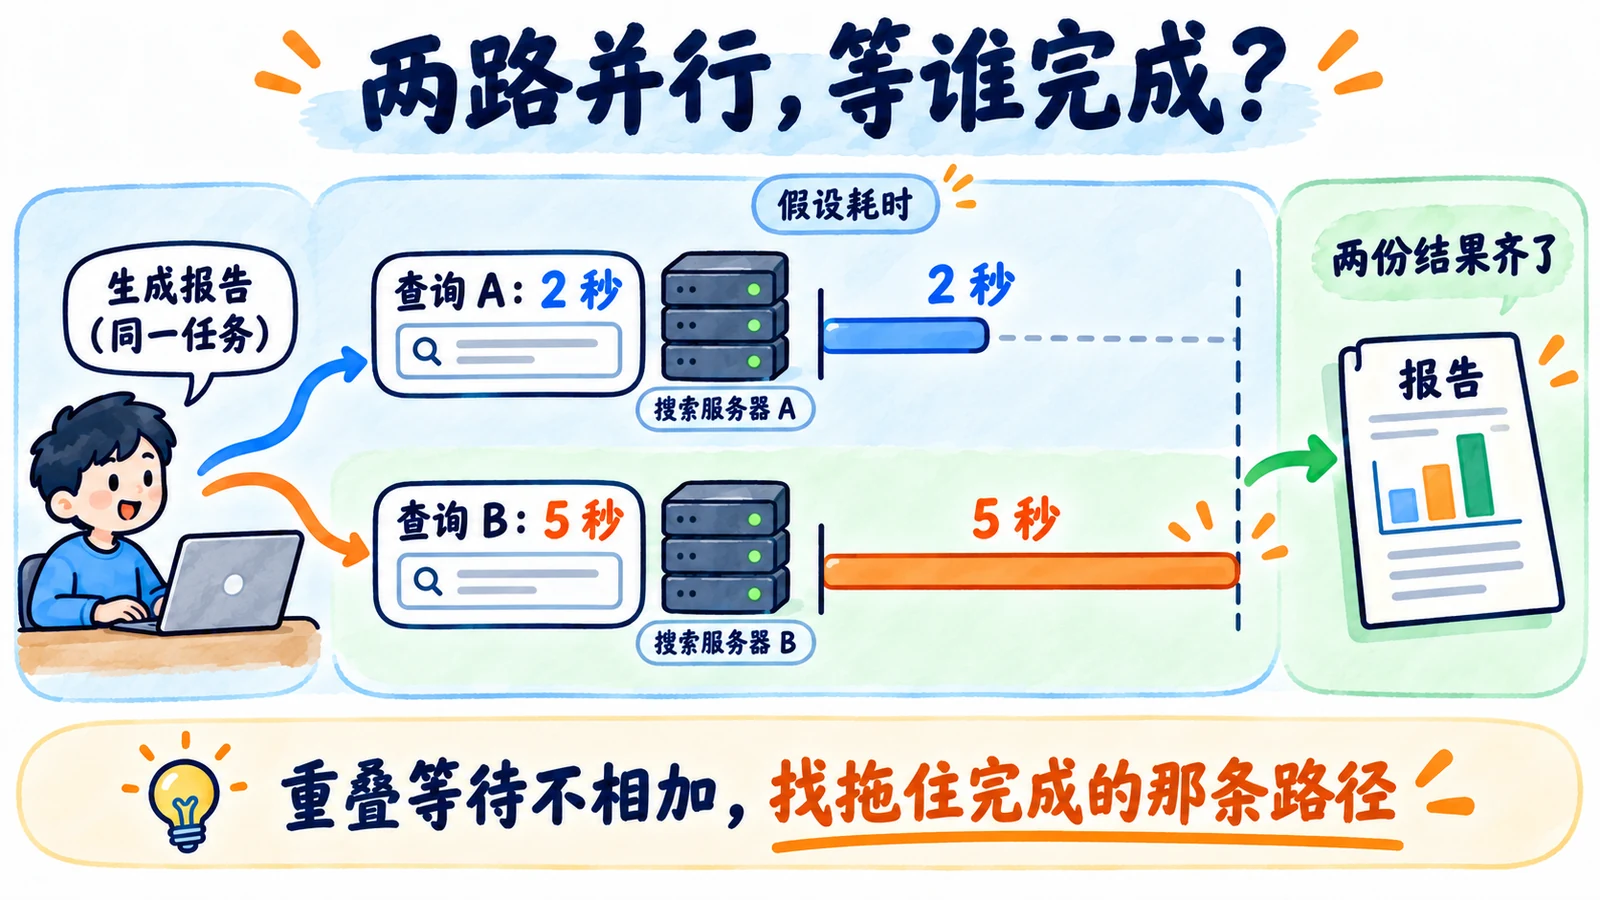
例如,两个搜索工具同时执行,一个用两秒,一个用五秒。程序要等两份结果都回来,才能写报告。那么这一段等待大约由较慢的五秒决定,而不是把两个工具的时间相加成七秒。
如果另外还有一项后台记录,用了十秒,但它没有挡住报告返回,就不能因为它的数字最大,便认定它是用户等待的主要原因。
这里需要找的是 关键路径 :哪些有先后依赖的步骤,决定了任务最早什么时候能完成。
同样,Trace 里面的父步骤可能已经包含子步骤的耗时。把父子时间重复相加,也会算出一个不存在的总耗时。应该结合开始、结束时间和等待关系来看,而不是只把所有数字加起来。
找到原因以后,怎样确认真的变快了?
还是用前面的企业调研任务。
如果原因是重复搜索,可以改进搜索结果的整理方式和停止条件;如果是两个互不依赖的查询串行执行,可以考虑局部并行;如果是队列拥堵,就要检查工作进程和下游容量,而不是无限增加并发。
这些都是根据排查结果提出的方案,不代表每种方案都应该一起做。
验证时,准备同一批公司、同样的报告要求,记录模型、提示词和工具版本,再比较改动前后的结果。除了平均耗时,还要看慢请求的变化。例如,P95 耗时表示约 95% 的任务在这个时间内完成,能帮助发现少部分特别慢的请求。
同时检查报告是否漏掉必要信息、错误和重试是否增加、单次任务成本有没有变化。一次任务提前结束,却没完成目标,不能算优化成功。
还要区分“先显示文字”和“整份报告完成”。流式输出可以让用户早点看到内容,但不能据此推断整个任务已经更快。LangSmith 的生产监控说明也分别观察首 Token 时间、执行延迟和成本。
面试官继续追问
线上只有部分任务慢,应该看什么?
把慢任务和正常任务放在一起,比较输入长度、执行轮次、失败重试和下游返回时间。还可以按任务类型、版本和并发量分组。
只看全部请求的平均值,会把少数特别慢的任务盖住。需要找到这些任务共同多了哪一步、等了哪一项资源。
上下文长,是不是直接做摘要就行?
先确认长上下文确实造成了主要延迟,再检查哪些内容可以压缩。
企业调研里的网址、关键数字和信息来源可能是报告需要的证据。摘要如果把这些信息删掉,模型可能重新搜索,最后反而增加轮次。压缩要保留后续判断需要的内容,并让原始资料可以重新取回。
并发开大一点,排队不就少了吗?
可能少,也可能把等待转移到模型服务或搜索接口。
如果下游只能承受有限请求,同时发出去太多,限流和超时就可能增加。因此,要结合下游容量做压测,观察完成数量、尾部延迟和错误率,而不是只看队列长度下降了没有。
面试速记卡
- 排查起点:从用户提交到任务完成,记录完整等待时间。
- 拆分方式:区分排队、模型、工具、重试和执行轮次。
- Trace:把一次任务里的调用关联起来,解释哪一步发生了变化。
- 关键路径:看哪些等待拖住最终完成,不能重复累加重叠耗时。
- 优化验证:同一批任务比较耗时、质量、错误和成本。
- 流式输出:早点看到内容,不等于整个任务更早完成。