
Transformer 的 Attention 是怎么计算的?Q、K、V 分别有什么用?
🧑💻 面试官:Transformer 里的 Q、K、V 分别有什么用?
🙋♂️ 我:Q 是查询,K 是键,V 是值,用它们计算注意力。
🧑💻 面试官:这几个名字我知道了。但它们从哪里来?为什么不直接用原来的词向量?
🙋♂️ 我:可以通过不同的矩阵变换得到,让它们承担不同的计算。
🧑💻 面试官:那 Q 和 K 算出分数以后,为什么还要乘 V?这个结果和“生成下一个词”是一回事吗?
这道题可以顺着一个过程讲:「算权重,再汇总信息」。Q 和 K 参与计算权重,V 提供被汇总的内容;Attention 输出的是新表示,不是直接选出一句答案。
面试速答(60 秒版)
Attention 的作用,是让当前位置根据其他位置的信息,得到一个结合上下文的新表示。
在 Self-Attention 中,同一组输入分别经过可学习的矩阵变换,得到 Q、K、V。Q 和 K 做点积,计算当前位置与其他位置的匹配分数。
这些分数除以缩放因子,再经过 Softmax,变成一组权重。随后,用权重对 V 加权求和,得到 Attention 输出。因此,Q 和 K 主要用于决定信息怎样分配权重,V 则提供参与汇总的信息。
多头注意力使用多组投影分别计算,再把结果拼接并变换。对于自回归生成,还需要遮住未来位置,避免使用尚未生成的内容。Attention 本身只是模型内部的一段计算,后面还需要其他网络层和输出处理,才能得到下一个 Token 的概率。
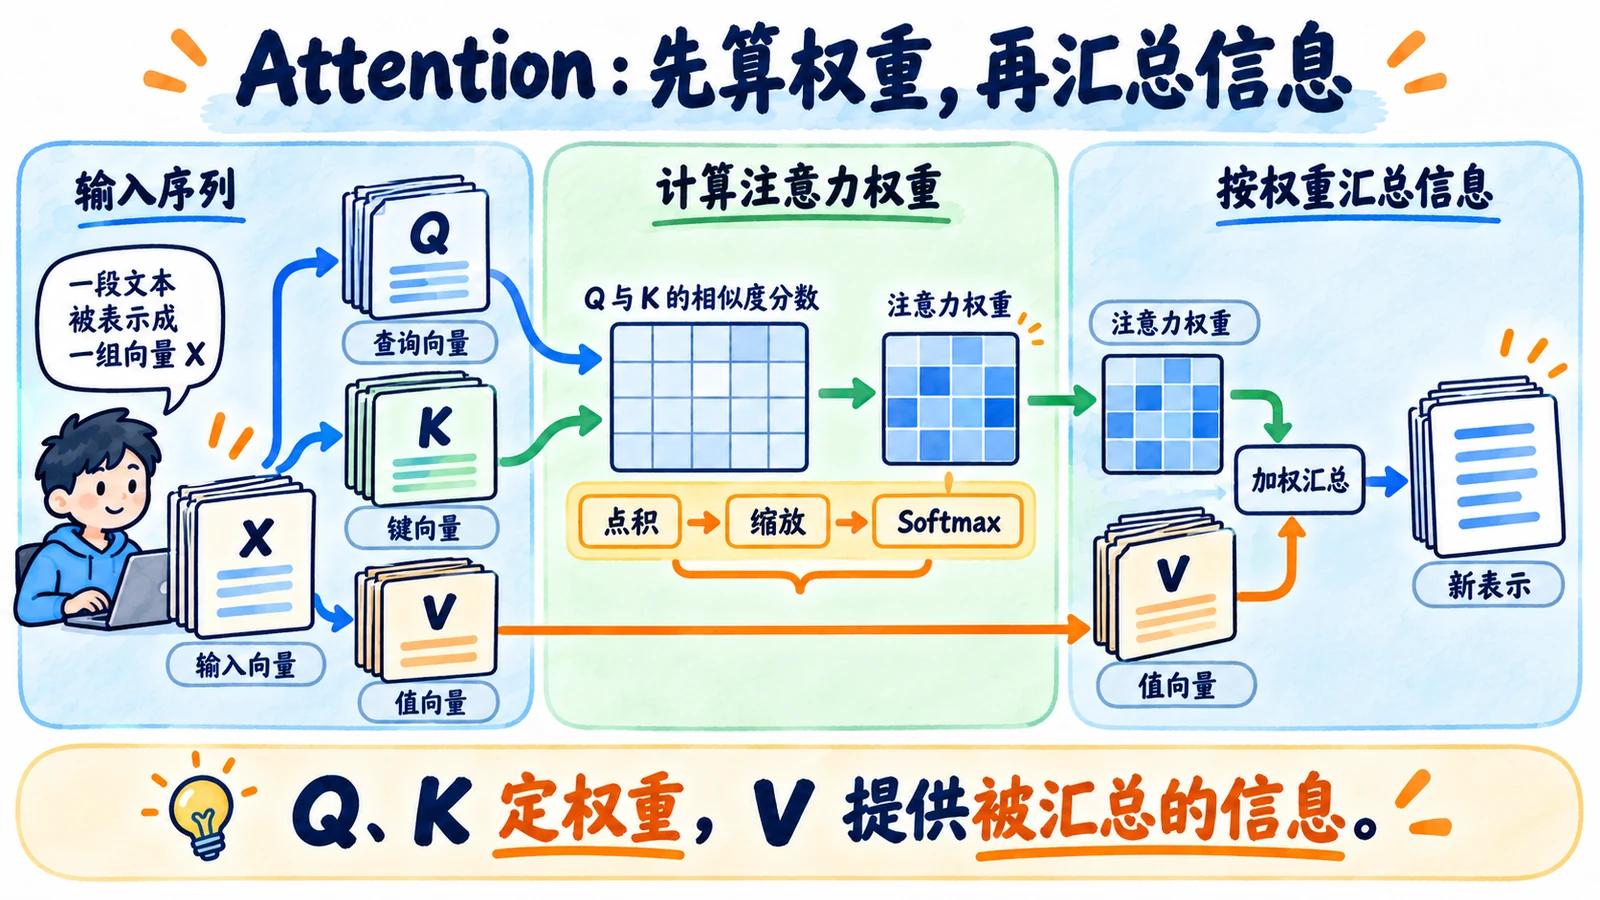
知识点详解:从输入向量,到 Attention 输出
先理解,它要解决什么问题
假设咱们看到一句话:“猫睡了,它很安静。”
理解“它”的时候,只看这个字本身,信息是不够的。前面出现的“猫”,能够帮助判断这里在说谁。
Attention 就允许当前位置读取其他位置的信息。不过,模型处理的不是汉字卡片,而是一组数值向量。为了方便讲解,下面只取“猫”“睡了”“它”三个简化位置;真实模型的分词可能不同,也不会靠我们手写规则完成这个判断。
设这些位置当前的表示组成矩阵 X。到了较深的网络层,X 已经是前面各层处理后的表示,不一定是最初的词嵌入。
接下来,模型需要做两件事:计算不同位置应该分到多少权重,再按这些权重汇总信息。
Q、K、V 不是人写进去的三个标签
在单头 Self-Attention 中,可以把它们的来源写成:
Q = XWq,K = XWk,V = XWv
Wq、Wk、Wv 是训练中学习得到的参数矩阵。它们把同一组输入变换成三组表示,分别参与后续计算。
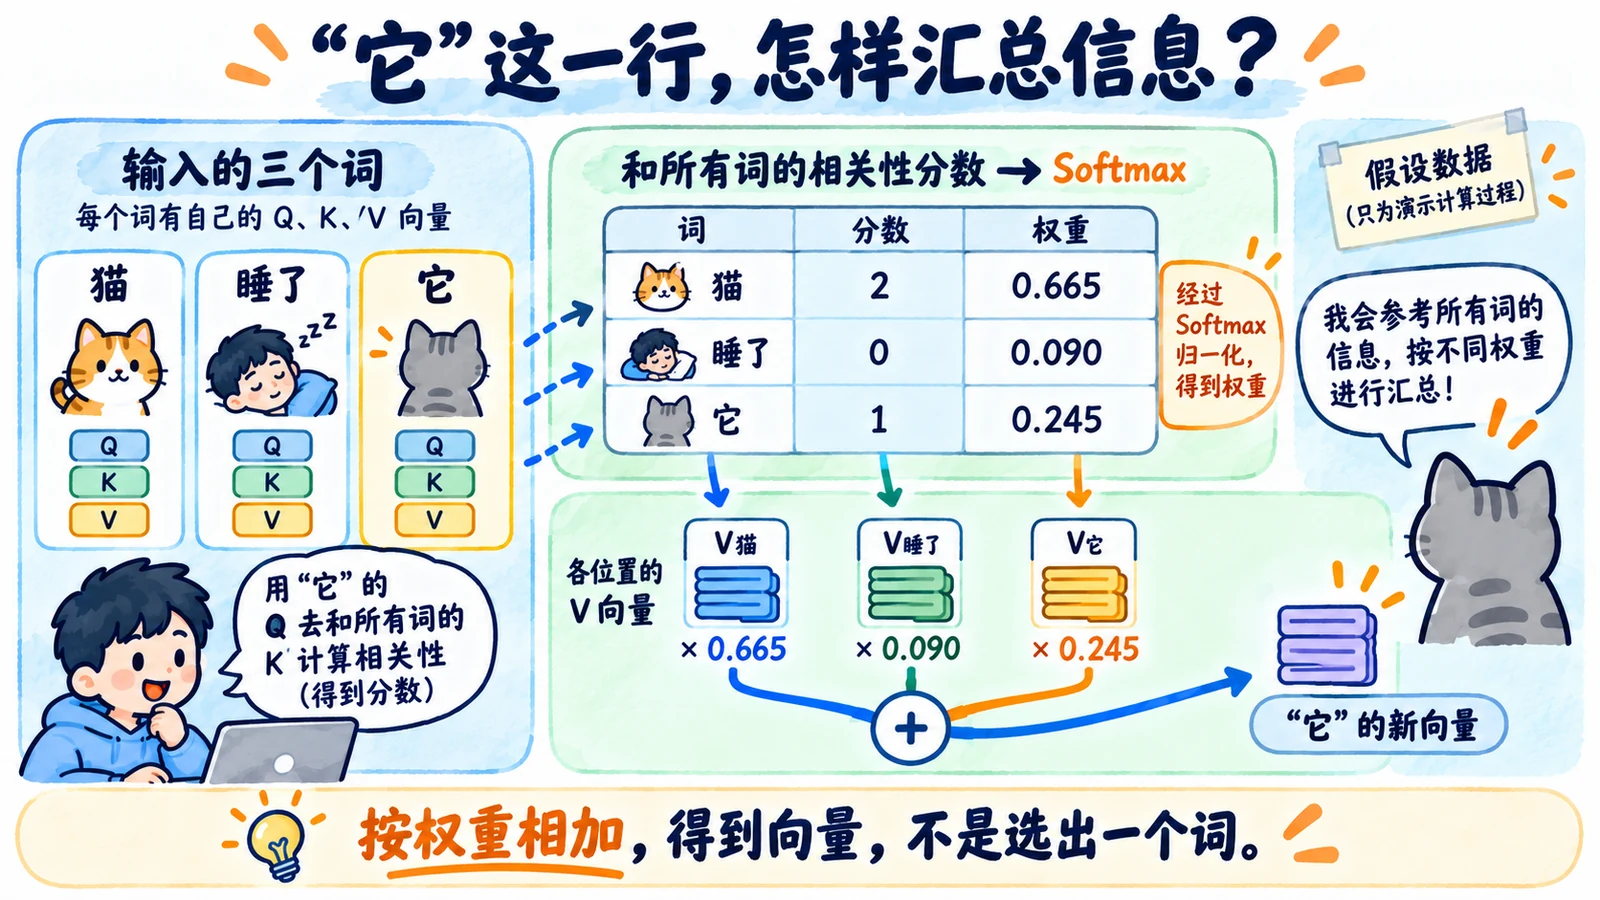
对于“它”这个位置,用它的 Q 和各个位置的 K 做点积,就能得到一行匹配分数。对于“猫”等其他位置,也会做相同的计算,所以完整结果是一张位置之间的分数表。
为什么要使用不同的投影,而不是直接拿 X 做所有事情?
因为“怎样判断匹配”和“最终要汇总什么信息”不必使用完全一样的表示。模型通过学习投影参数,可以调整这两类计算。Q、K、V 的英文名字只是帮助记忆,并不表示模型里真的有三份自然语言的“问题、目录和答案”。
标准计算的形式为:
Attention(Q, K, V) = softmax(QKᵀ / √dk)V
其中 dk 是每个 Key 的维度。Transformer 原论文给出了这套缩放点积注意力。
Softmax 之后,V 怎样参与计算?
仍然看“它”这一行。
假设它与三个位置的缩放后分数,分别是 2、0、1。经过 Softmax,得到的权重大约是:
| 位置 | 假设分数 | 归一化权重 |
|---|---|---|
| 猫 | 2 | 0.665 |
| 睡了 | 0 | 0.090 |
| 它 | 1 | 0.245 |
这是为了演示运算而设置的数字,不是“代词一定关注猫”的实测结果。
Softmax 把这一行分数转换成总和为 1 的权重。分数较大的位置分到较大权重,但通常不只是保留分数最大的那一个。
接下来,计算:
输出 = 0.665 × V猫 + 0.090 × V睡了 + 0.245 × V它
这里的 V猫 等仍然是向量。把它们按权重相加,得到的也是一个向量,是“它”这个位置更新后的表示。
因此,QK 的分数不是最终输出。只算匹配分数,还没有完成信息汇总。最后乘 V,才把各位置的内容按当前权重组合起来。
缩放、掩码和多头,又分别在做什么?
先看缩放。点积会受到向量维度等因素影响。分数过大时,Softmax 可能变得非常尖锐,不利于训练。标准 Attention 用 √dk 做缩放,而不是任意选一个常数。
再看掩码。自回归模型生成内容时,当前位置不能提前读取未来位置。程序会在 Softmax 之前,屏蔽这些位置的分数,让它们不参与本次信息汇总。PyTorch 的对应算子展示了缩放、掩码和聚合的顺序。
最后看多头。只使用一组投影,相当于按一套学习到的变换计算关系。多头使用多组投影,分别得到结果,再拼接并进行输出变换。
可以理解为,模型同时学习多种信息组合方式。但不能固定说“第一头看语法,第二头看指代”,每个头的作用是训练结果,不是开发者事先给它分配的栏目。
算完这些以后,还要经过残差连接、前馈网络等后续处理。到模型输出端,才会转换成下一 Token 的概率。因此,Attention 权重和词表输出概率,也不能混为一谈。
面试官继续追问
Self-Attention 的 Q、K、V 都来自同一组输入,那 Cross-Attention 呢?
Cross-Attention 的 Query 来自当前要更新的表示,Key 和 Value 来自另一组提供信息的表示。
例如,原始编码器—解码器 Transformer 中,解码器使用自己的表示提出查询,再读取编码器输出。计算方式相近,但信息来源不同。
Q、K、V 的维度必须完全相同吗?
不必。点积要求对应的 Q 和 K 维度能够匹配;V 的维度可以不同。
Attention 权重在位置维度上对 V 加权,因此输出特征维度由 V 等后续投影决定,不能只因为写着三个字母,就认为它们的形状完全相同。
为什么长上下文会增加 Attention 的计算?
标准稠密 Self-Attention 需要计算许多位置两两之间的分数。序列长度增加,会让这部分工作按平方量级增长。
具体实现可以优化内存访问,或者采用不同的注意力结构。但不能仅因为使用了优化算子,就把标准稠密注意力说成没有位置两两比较。
面试速记卡
- 来源:Self-Attention 的 Q、K、V 来自输入的不同可学习投影。
- 权重:Q 和 K 点积,缩放后经过 Softmax。
- 内容:权重作用到 V,加权汇总得到新表示。
- 掩码:生成时遮住未来位置,不让当前位置提前读取。
- 多头:多组投影分别计算,拼接后再变换。
- 输出:Attention 表示不是下一 Token 的词表概率。