
Redis 为什么快?“单线程”与多线程 I/O 应该怎样理解?
🧑💻 面试官:Redis 为什么快?
🙋♂️ 我:常见操作主要访问内存,数据结构适合对应访问,命令执行路径也比较短。
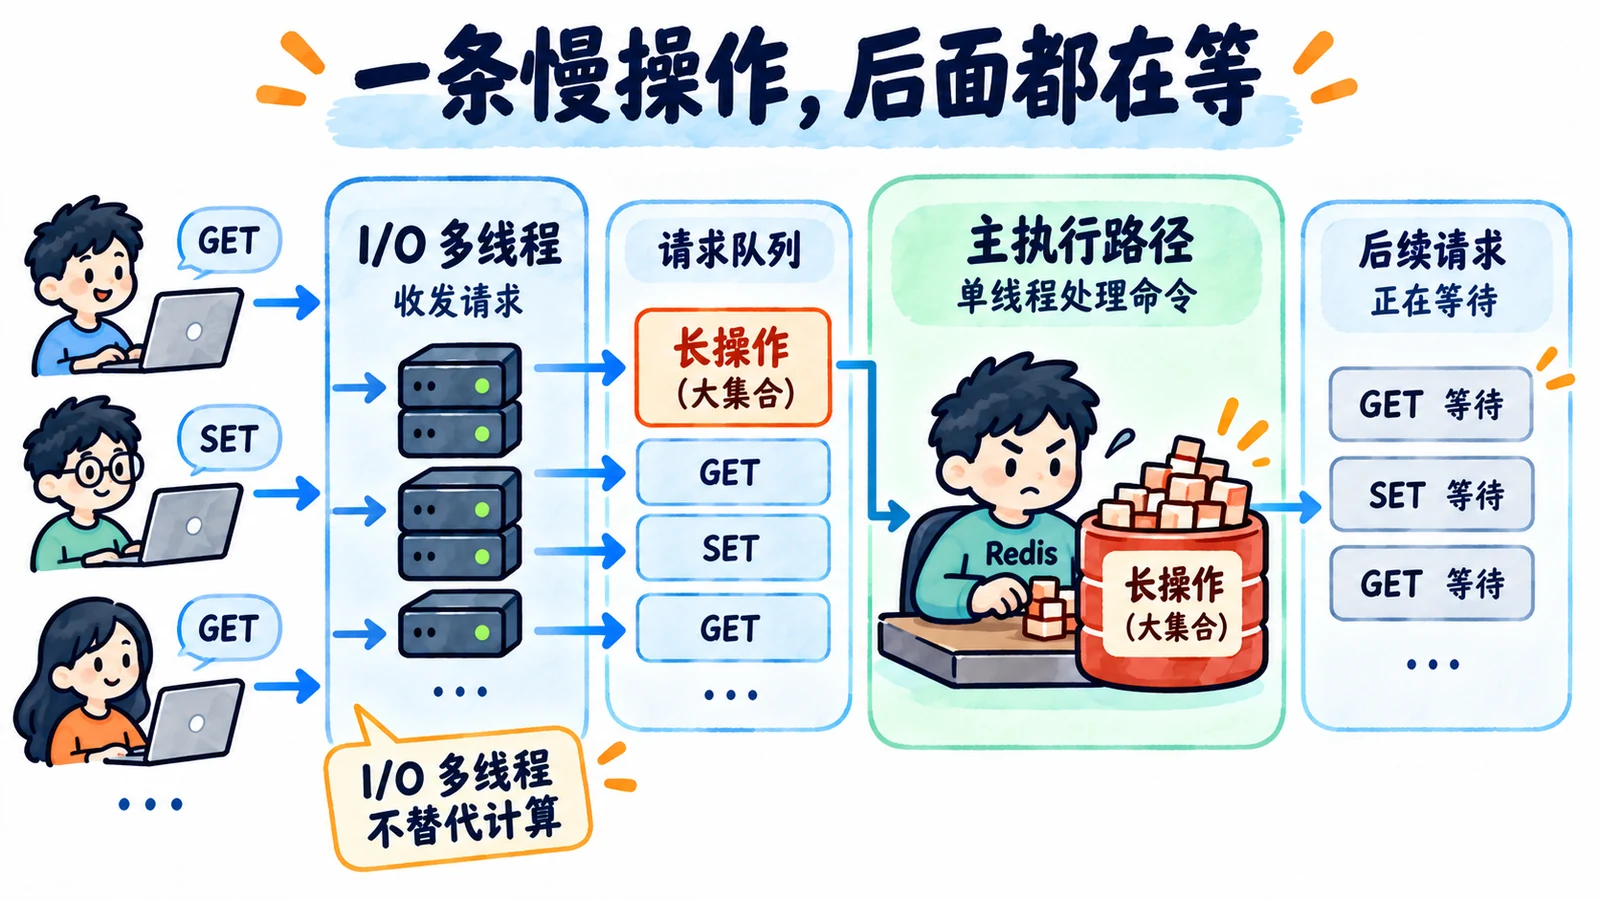
🧑💻 面试官:如果“放内存就快”,一个 O(N) 的大集合操作也不会卡吗?
🙋♂️ 我:仍然可能卡住命令执行线程,内存访问不是没有成本。
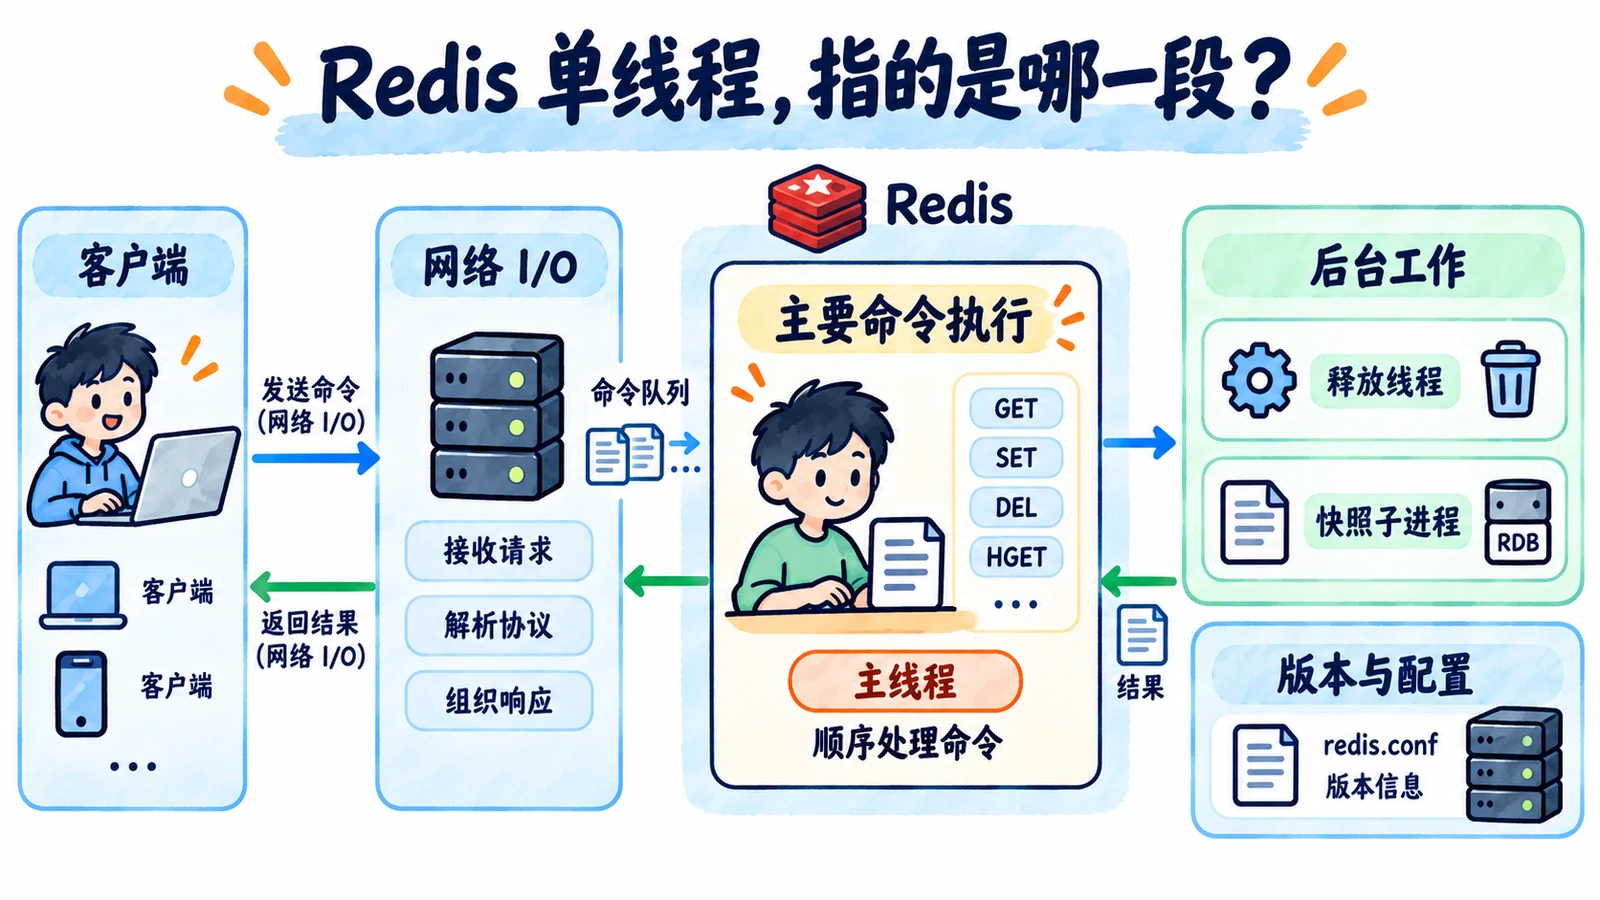
🧑💻 面试官:Redis 有多线程 I/O,又有后台工作。那“Redis 单线程”这句话到底指哪一部分?
先把「网络收发、命令执行、后台工作」拆开,才不会把整个 Redis 进程误认为只有一个线程。
面试速答(60 秒版)
Redis 快,是多个因素共同作用。常见数据操作主要访问内存,键查找和不同数据类型采用相应结构,网络事件处理也避免为每个连接都创建一个执行线程。
“单线程”通常指常见命令的主要执行路径由主线程串行处理,不是说整个进程没有其他线程或子进程。后台释放、持久化相关工作,以及配置支持的网络 I/O,都可能由其他执行单元承担。
因此,多线程 I/O 可以改善网络收发,但不代表两个任意命令都在不同核心上同时修改数据。具体行为还要按版本、配置和命令核对。
同时,大 key、复杂命令、长脚本和持久化压力仍可能造成延迟。单条命令原子执行,也不等于多条业务命令自动组成原子操作。
知识点详解:一次 GET 请求,时间花在哪里?
先沿着请求走一遍
假设客户端执行 GET,服务端需要接收网络字节、解析请求、查找 key、读取对应值,再把响应发回客户端。
常见键查找可以利用哈希等数据结构,读取内存也通常比等待磁盘随机 I/O 更直接。很多常用命令的处理步骤较短,因此请求能很快完成。
但请求路径还包括网络往返、排队、对象编码以及响应大小。读取一个小字符串与发送几十兆的大值,不可能因为都叫 GET 就有同样延迟。
因此,“快”要结合具体命令与数据规模讨论,不能只给整个产品贴一个固定毫秒数。
单线程主要执行命令,有什么好处和限制?
常见命令在主执行路径串行处理,可以减少共享数据操作中的许多锁竞争,也让单条命令的状态修改有清楚的顺序。
不过,串行意味着一条耗时操作占用主线程时,其他命令需要等。大集合遍历、长脚本或某些大对象删除,都可能延长等待。
Redis 的延迟诊断文档解释了命令、fork 和系统资源等不同来源的延迟。它不是在说内存里所有操作都很便宜。
多线程 I/O 为什么不等于多线程执行所有命令?
网络收发和命令修改数据,是两个阶段。可以让 I/O 线程处理部分收发工作,再由主要执行路径处理命令。
这样可能减少网络处理占用的时间,但如果瓶颈是一段长脚本或者大集合计算,增加 I/O 线程并不会自动把它拆成多核计算。
Redis 不同版本会调整 I/O 工作分配与配置行为。以 Redis 8.0 配置说明为例,需要核对 I/O 线程相关配置,不能把早期版本的一句话沿用到所有未来版本。
后台工作也不能全部叫 I/O 线程。后台释放可能使用线程,后台快照或重写还可能涉及子进程。讲清楚工作分工,比数整个进程有几个线程更重要。
命令原子执行,为什么业务仍可能出错?
假设业务先 GET 余额,再计算新值,最后 SET。
这两条命令之间,其他客户端可能修改余额。即使每一条命令本身都按顺序完整执行,这段业务也不自动原子。
可以使用满足业务要求的原子命令,或者合适的事务、脚本与版本条件。但脚本运行得太久,也会影响其他请求;Redis 事务的错误处理也不能按关系数据库回滚方式想象。
同时,原子执行并不等于持久落盘。服务串行执行了 SET,发生故障后是否能恢复,还要看持久化和复制规则。
面试官继续追问
Pipeline 为什么能提速?
它可以减少客户端逐条等待网络往返,把多条请求集中发送并读取响应。
它没有把每条命令的计算量变小,也不自动把这些命令组成原子事务。批量过大还可能占用连接和缓冲,增加其他请求等待。
Redis 变慢,先开更多线程吗?
先区分网络等待、服务排队和命令执行时间。
检查慢查询、延迟事件、CPU、内存、交换空间、大 key 和持久化活动。慢查询记录不包含客户端经历的所有等待,所以“没有慢命令”也不能单独证明服务很快。
怎样验证优化有效?
用真实命令类型、key 和值大小、读写比例以及到达速率压测,同时看吞吐和 P95/P99 延迟。
不能只跑小值 GET,再用这个结果代表大集合业务。优化网络与优化慢命令,也要分别对照,才能知道收益来自哪里。
面试速记卡
- 速度来源:内存访问、合适的数据结构和较短的常见执行路径。
- 单线程口径:主要命令执行路径,不是整个进程。
- I/O 多线程:处理网络相关工作,不等于任意命令并行修改数据。
- 阻塞风险:大对象、复杂命令、长脚本和系统资源压力。
- 原子边界:单命令原子,不自动保证业务原子或数据持久。