
向量数据库是怎么快速检索的?HNSW 和 IVF 有什么区别?
🧑💻 面试官:知识库里有很多文档,向量数据库为什么能很快找到相似内容?
🙋♂️ 我:因为它会计算问题向量和文档向量的相似度。
🧑💻 面试官:如果每次都把全部向量计算一遍,数据越多,不还是越慢吗?
🙋♂️ 我:那就需要索引,比如 HNSW 或者 IVF,减少搜索范围。
🧑💻 面试官:它们分别怎么减少范围?没有检查的向量里,恰好有最相似的那个怎么办?
这道题要讲清的是:「少算了什么」。索引通过减少比较提速,但也可能漏掉真正的近邻;HNSW 和 IVF 省掉比较的方式不同。
面试速答(60 秒版)
向量检索最直接的做法,是把查询向量和全部文档向量比较,再选出最接近的几个结果。数据量大以后,这样的全量扫描可能比较慢,因此会使用近似最近邻索引。
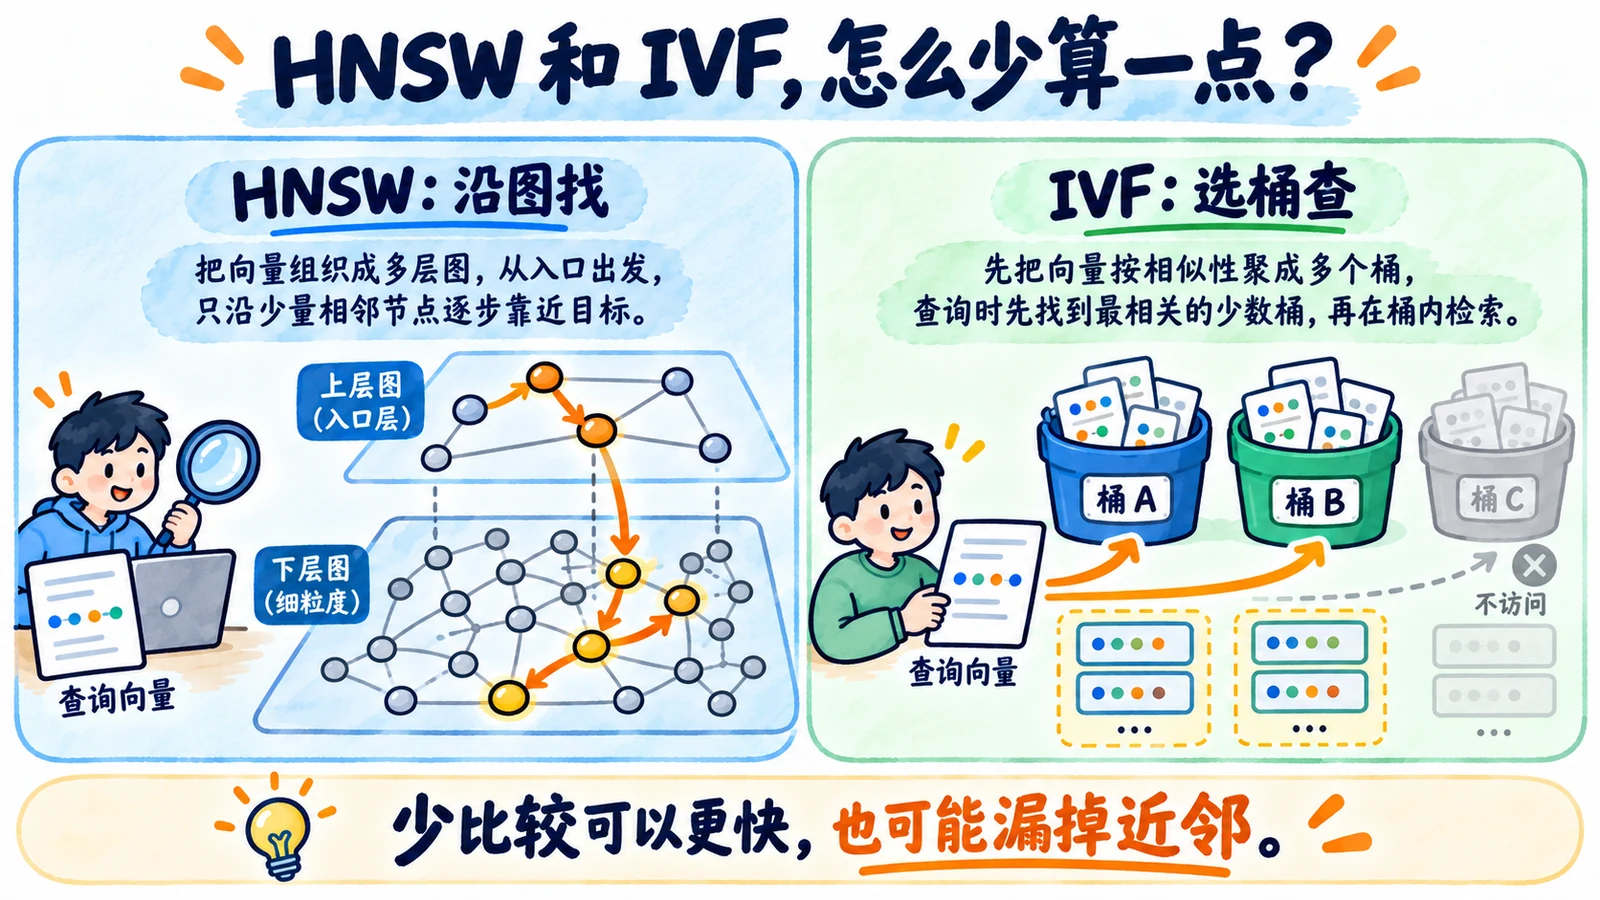
HNSW 把向量组织成分层的邻近图。查询先在上层找到比较合适的方向,再进入下层,沿着相邻节点继续搜索。
IVF 则先把向量分到不同的桶里。查询时选择几个接近的桶,只比较这些桶中的候选向量。
因此,它们都可能漏掉没有搜索到的近邻。实际选型时,要结合数据量、内存、更新方式和过滤条件,用同一批查询比较召回率与耗时。不能只看哪个索引跑得快,也不能把向量相似理解成业务答案一定正确。
知识点详解:HNSW 和 IVF 分别怎样减少搜索?
先弄清楚:不使用近似索引,会怎样搜索?
假设咱们有一个企业知识库,用户想查询“出差住宿可以报销多少”。
应用先把问题转换成向量,再按照选定的距离或相似度,比较它和文档向量的接近程度,取排名靠前的结果。
最直接的方式,就是每个文档向量都比较一次。这个过程叫全量扫描。在相同数据和距离规则下,它可以作为精确近邻的参考答案。Faiss 的索引说明中的 Flat 索引就是这种方式。
不过,精确的是“按这个距离规则找到最近的向量”,不是“找到业务上最正确的答案”。向量模型如果没有很好地表达“国内”和“海外”的差别,精确搜索也可能把不适用的报销制度排到前面。
索引主要解决搜索效率。文档内容、向量质量和最终答案,则是后面还要检查的事。
HNSW:沿着邻近关系找,不逐个扫描全部向量
HNSW 会把向量当成图里的节点,并为节点建立邻近关系。搜索时,可以从当前节点继续访问它的邻居,逐步寻找更接近问题向量的候选。
如果只有一张密集的图,搜索仍然可能需要走很多步。因此,HNSW 还设置了多个层级:上层只有部分节点,适合先找到搜索方向;下层节点更多,再做更细的搜索。HNSW 原论文介绍的就是这种分层邻近图。
咱们查询住宿报销规则时,不是先检查每篇文档,而是从图的入口开始比较,沿着邻近关系扩展候选,最终返回找到的近邻。
那么,它是不是一定能沿着图走到真正最近的向量?
不一定。它没有遍历所有节点,结果还受到图结构和搜索范围的影响。以 Faiss 为例, efSearch 控制搜索时保留和探索候选的范围,通常调大能改善索引召回,但会增加搜索工作。它不是最终返回数量 top_k 的另一个名字。
IVF:先决定搜哪些桶,再比较桶里的向量
IVF 的思路和 HNSW 不同。
它先利用一批有代表性的向量,学习若干聚类中心,再把数据分配到对应的桶。桶里保存的是分到这里的候选向量;这些桶也叫倒排列表。
查询时,先比较问题向量和各个中心,选出几个接近的桶,再搜索这些桶里的数据。
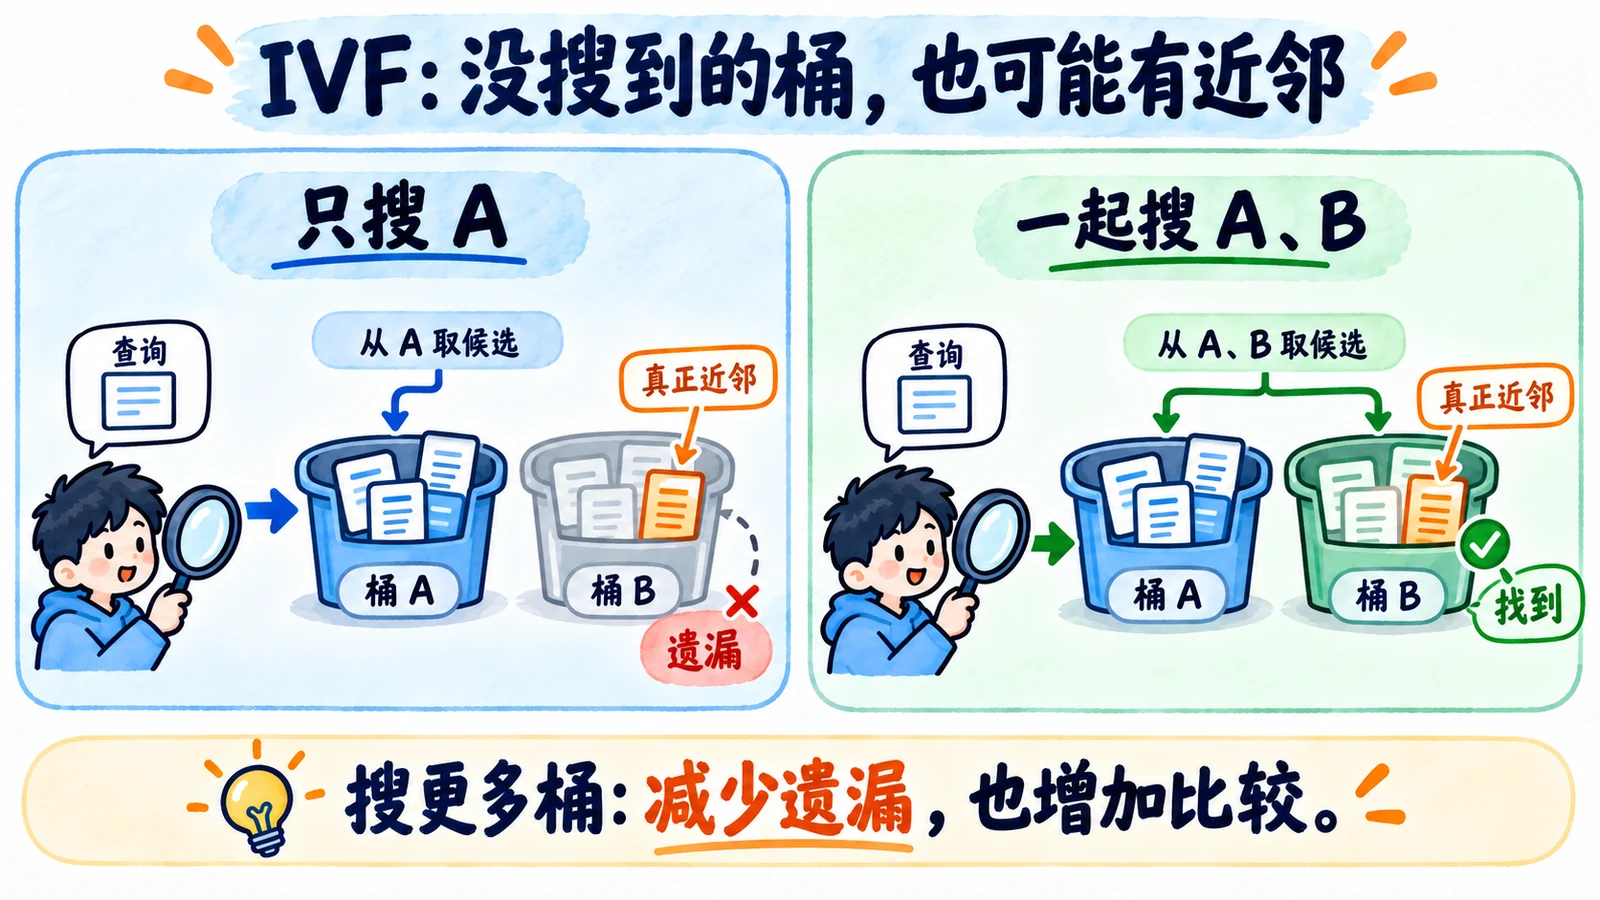
例如,问题向量最接近桶 A,但程序还可以一起搜索桶 B 和桶 C,降低只查一个桶带来的遗漏。Faiss 用 nprobe 表示一次搜索多少个桶,用 nlist 表示总桶数。
如果最接近的文档被分到了没有选中的桶,就可能漏检。所以,增加 nprobe 通常能提升召回,也会让查询比较更多数据。
这里还有一个容易混淆的地方: IVF 不等于向量压缩。 IVFFlat 保留原始向量,在选中的桶里直接比较;IVFPQ 才另外使用 PQ 压缩表示。分桶和压缩,是两项不同的处理。Faiss 文档区分了这些索引形式。
实际选型,不只比较一次查询的速度
可以先把区别记成下面这样:
| 比较项 | HNSW | IVF |
|---|---|---|
| 组织方式 | 分层邻近图 | 聚类中心与倒排桶 |
| 搜索过程 | 沿图扩展候选 | 选择若干桶后搜索 |
| 主要搜索参数 | 如 efSearch | 如 nprobe |
| 建立索引 | 不需要 IVF 式的聚类训练 | 需要训练合适的聚类中心 |
| 需要额外关注 | 图连接占用的内存、构建参数 | 训练样本、桶分布、数据变化 |
这些是机制上的区别,不是“HNSW 永远更好”的排名。Faiss 的选型说明也根据内存、数据规模和精度要求给出不同选择。
验证时,可以先用全量扫描得到一批查询的精确前 k 个近邻,再看近似索引找回了其中多少。这个指标叫索引的 Recall@k。
同时记录查询耗时、索引内存和构建时间。如果业务需要按租户、时间或权限过滤,也要把过滤条件一起放进测试。某些实现先搜索再过滤,可能过滤完只剩很少结果;具体处理方式要看数据库,而不是只看索引名称。
最后,再检查这些结果能不能帮助用户正确回答报销问题。索引召回好,只能说明它接近精确向量搜索,不能单独证明 RAG 效果好。
面试官继续追问
数据量不大,也一定要使用 HNSW 吗?
不一定。先测试全量扫描能不能满足实际延迟要求。
如果数据不多、查询量有限,全量扫描可能已经够用,还省去了近似索引的调参和维护。索引的额外复杂度,需要有实际收益。
IVF 把全部桶都搜一遍,会怎样?
对于保留原始向量的 IVFFlat,搜索全部桶可以恢复全量比较,不再遗漏未搜索桶中的向量。
不过,这时候它已经没有靠缩小候选范围节省计算,额外的分桶管理还可能让它不如直接扫描。这个结论不能直接套到使用压缩向量的 IVFPQ 上。
把搜索范围调大,回答就一定更准确吗?
不能这样保证。
搜索范围变大,可以减少索引造成的遗漏。但如果文档过期、向量模型不适合业务,或者生成阶段没有读对证据,答案仍然可能错误。需要分别检查索引近邻召回和业务问答效果。
面试速记卡
- 全量扫描:比较全部向量,可以作为精确近邻参考。
- HNSW:先在上层找方向,再在下层沿邻近图搜索。
- IVF:先选择接近的桶,再比较桶内候选。
- 参数:扩大搜索范围通常提高召回,也增加耗时。
- 压缩:IVF 分桶不等于 PQ 压缩,IVFFlat 保留原始向量。
- 验证:索引召回不等于业务答案正确,两者都要检查。