
MySQL 明明只更新一条记录,为什么还会阻塞其他请求?
🧑💻 面试官:一条 UPDATE 只影响一行,为什么其他请求还会被它阻塞?
🙋♂️ 我:可能其他请求也要更新这一行,正在等它释放锁。
🧑💻 面试官:其他请求更新的是另一个任务,而且没有相同的主键,这时候呢?
🙋♂️ 我:需要看看这条 UPDATE 是不是用了合适的索引。
🧑💻 面试官:SQL 很快就执行完了,但事务一直等大模型返回才提交。锁会跟着 SQL 执行结束一起释放吗?
这里要分清:「改了几行」和「锁了什么、锁了多久」。影响行数说明最终修改结果,不能单独说明 InnoDB 的锁范围。
面试速答(60 秒版)
MySQL 的 UPDATE 只影响一条记录,不代表它只锁住这一条记录。要结合存储引擎、隔离级别和实际使用的索引来判断。
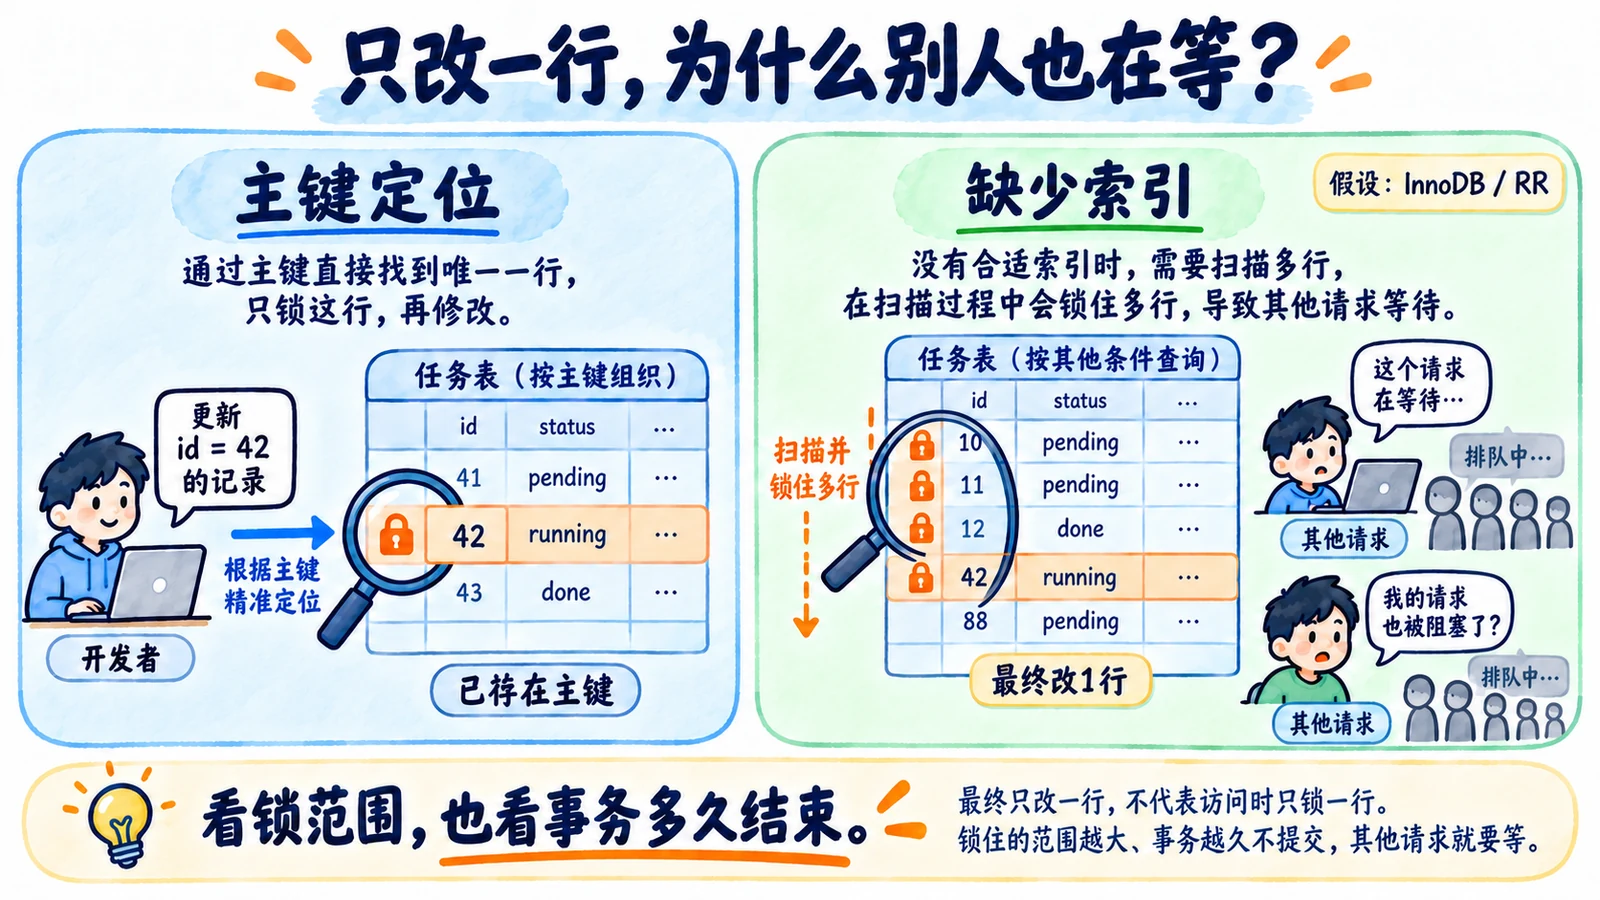
在 InnoDB 的常见可重复读场景中,通过唯一索引定位一条已存在的记录,通常只需要锁住对应索引记录。但如果使用范围条件、非唯一索引,或者没有合适索引,就可能在扫描过程中锁住更多记录或范围,让其他写请求等待。
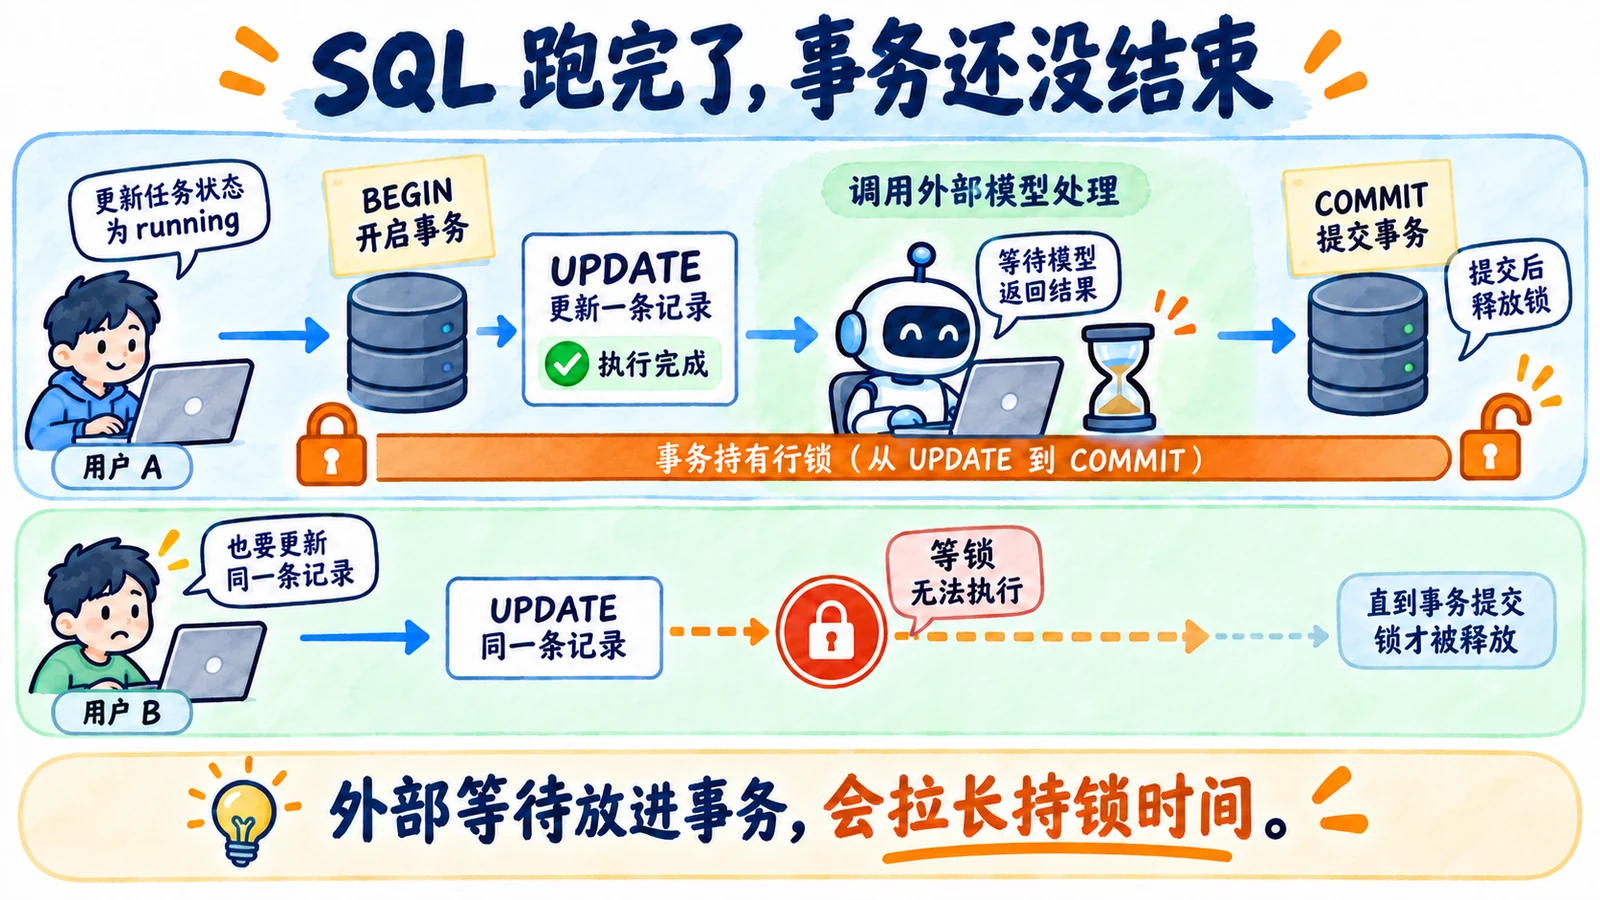
同时,锁的等待时间还和事务有关。SQL 执行完了,如果事务没有提交,相关锁通常仍然保留。把模型调用或外部接口放在事务里等待,就可能延长持锁时间。
因此,排查时要看执行计划、锁等待关系和事务持续时间。优化索引和缩短事务都可能有用,但不能只凭“影响一行”,就认定没有锁问题。
知识点详解:一行更新,为什么会挡住别的任务?
影响行数,记录的是更新结果
假设咱们有一张 agent_task 表,保存任务编号、外部请求编号和任务状态。
先看下面这个更新:
UPDATE agent_task
SET status = 'running'
WHERE id = 42;假设 id 是主键,记录 42 已经存在,也没有额外的外键或其他特殊约束。InnoDB 可以直接定位这条索引记录,再完成更新。
接下来,换一种查找方式:
UPDATE agent_task
SET status = 'running'
WHERE request_key = 'req-42';假设 request_key 没有索引,即使数据中只有一条记录符合条件,数据库也需要检查许多记录,才能找出它。
因此,两条 SQL 最后可能都只修改一行,但找到这一行的过程不同。 影响行数不会告诉你,中间扫描并锁住了哪些索引记录。
MySQL 的锁说明指出,UPDATE 通常会对扫描到的索引记录设置锁,而不只是针对最终满足 WHERE 条件的行。锁的具体保留和释放,还受到隔离级别等条件影响。
记录锁、间隙锁和临键锁,分别挡住什么?
InnoDB 主要围绕索引设置这些锁,不是把“业务对象”作为唯一判断依据。
记录锁锁住索引中的某条记录。例如,另一个事务也要修改已被锁住的记录,就可能等待。
间隙锁针对索引记录之间的区间,主要影响向这个区间插入新记录。它不是简单地把已有某一行“多锁一次”。
临键锁,也叫 next-key lock,可以理解为索引记录锁和它前面间隙的结合。在可重复读隔离级别下,范围扫描等情况可能使用它,防止范围里的记录集合在事务中发生不允许的变化。
MySQL 的隔离级别文档区分了唯一条件定位已存在记录,以及非唯一条件、范围扫描的锁处理。
所以,如果两个任务编号不同,也不能直接证明它们互不影响。它们可能位于同一个扫描范围内,也可能有插入动作落在被锁住的间隙中。
还要注意,“扫描了很多记录并设置锁”不等于 InnoDB 自动把行锁升级成一个表锁。排查时应该说清实际索引和锁类型,而不是看到大面积阻塞就一律说“锁表了”。
SQL 执行完了,为什么别人还在等?
咱们再回到 AI 任务更新。
应用开启事务,把任务状态改成 running,接着调用大模型生成结果,最后把结果写回数据库并提交事务。
看起来,第一次 UPDATE 很快就完成了。但事务还没结束,在大模型返回之前,其他操作可能仍然需要等待相关锁。
这段等待如果持续很久,数据库连接也一直被占用。请求增多以后,既可能出现锁等待,也可能耗尽连接池。
因此,不要把事务理解成“一条 SQL 正在运行”。事务从开始到提交或回滚,可能包含多条语句和应用等待,锁的持有时间也会受到整个事务的影响。
对这类任务,一种更合适的安排是:用短事务领取任务、提交状态;在事务外调用模型;拿到结果以后,再用短事务检查任务版本或执行权并写入结果。
这不是把前后两次写入假装成同一个原子操作。拆开以后,需要处理任务被取消、工作进程重启和旧结果晚到等情况。缩短事务要和状态校验一起设计,不能只删掉 BEGIN 和 COMMIT。
排查时,应该找到哪几份证据?
先找到阻塞请求和持锁事务,确认究竟是谁在等谁。Performance Schema 的 data_lock_waits 表能提供请求锁与阻塞锁之间的关系。
再查看 SQL 的执行计划,确认使用了哪个索引、扫描范围有多大。可以使用合适的 EXPLAIN 查看计划;不要为了线上诊断,随意执行会真正运行写语句的分析操作。
接下来,核对事务开始时间、是否已提交,以及应用当时在等待什么。慢的是锁等待,还是查询本身耗时,也要分开。
如果补充索引,验证实际计划有没有改变;如果缩短事务,验证失败重试、重复领取和状态变更是否仍然正确。不能只看到阻塞减少,就忽略任务被重复执行的问题。
面试官继续追问
改成 READ COMMITTED,是不是就没有这个问题了?
不是。READ COMMITTED 会改变部分范围锁和不匹配记录的处理,但记录冲突、长事务和某些约束检查仍然可能产生等待。
隔离级别还会影响业务允许看到什么数据。需要按业务一致性要求选择,不能把切换隔离级别当成所有锁问题的通用修复。
普通 SELECT 也会被 UPDATE 挡住吗?
在 InnoDB 常见的非 SERIALIZABLE 场景中,普通一致性读通常通过 MVCC 读取快照,不需要等待这些记录写锁。
但 SELECT FOR UPDATE 等锁定读不同,还要考虑元数据锁等其他原因。因此,先弄清楚执行的是哪种查询,不能笼统说“所有读都不会阻塞”。
查询条件有索引,为什么仍然锁得多?
索引存在,不代表执行计划一定使用它;使用了索引,也不代表条件是唯一等值查找。
范围很大、非唯一条件匹配较多,或者使用了其他访问路径,都可能扩大扫描和锁范围。要检查实际计划,不能只看建表语句里有没有索引。
面试速记卡
- 影响行数:说明最终改了多少,不说明扫描和锁住了多少。
- 锁范围:结合索引、查询条件和隔离级别判断。
- 唯一定位:已存在记录的唯一等值查询,通常能缩小锁范围。
- 持锁时间:SQL 完成不等于事务结束,等待模型可能延长持锁。
- 排查证据:执行计划、锁等待关系、事务持续时间。
- 优化边界:缩短事务后,仍要保证状态校验和重复执行处理。